Skip to content

FlashAttention 笔记

Standard Self-Attention

S=QKT,(N×N)P=softmax(S),(N×N)O=PV,(N×d)

Safe Softmax

safesoftmax=eximj=1Nexjm

计算 safe-softmax 的时候需要对 [1, N] 重复三次,需要访问 Q 和 K 三次, 并实时重新计算 x,很低效,现在希望将计算进行合并。

现在定义

di=j=1iexjmi

当 i = N 的时候,有:

dN=dN=j=1iexjmN

didi1 有如下递归关系:

di=j=1iexjmi=(j=1i1exjmi)+eximi=(j=1i1exjmi1)emi1mi+eximi=di1emi1mi+eximi

递归关系只依赖 mi1mi,于是可以把 dimi 放在同一个循环中。

FlashAttention V1

online softmax 最多只有一个 2-pass 的算法,不存在 1-pass 算法,但是 Attention 可以有 1-pass 算法。基于上述的 online softmax 可以得到一个 1-pass 的 Attention 算法。

重点在第二个循环:

ai=eximNdNoi=oi1+aiV[i,:]

推导 1-pass 版本的 FlashAttention:

oi=(j=1i(exjmidi)V[j,:])i=NoN=oN=(j=1i(exjmNdN)V[j,:])

推导 oioi1 之间的关系:

oi=(j=1i(exjmidi)V[j,:])=(j=1i1(exjmidi)V[j,:])+(eximidi)V[i,:]=(j=1i1(exjmi1di)exjmiexjmi1di1diV[j,:])+(eximidi)V[i,:]=oi1di1emi1midi+(eximidi)V[i,:]

可以看到 oioi1 递归关系不依赖 mn,因此可以将第二个循环完全合并到第一个循环中去。

FlashAttention V2

主要做了工程上的优化:

  • 减少大量非矩阵乘的冗余计算,增加 Tensor Core 的计算比例
  • forward pass/backward pass 均增加 seqlen 维度的并行,forward pass 交替 Q,K,V 循环顺序
  • 更好的 Warp Partitioning 策略,避免 Split-K

在 Tri Dao 的 FlashAttention 的 Triton 实现中,使用了 LSE(LogSumExp) 来做 smooth maximum。

softmax=exp(xic)iexp(xic)c=max(x1,...,xn)

LSE 可以被用于作为 approximation of max。

LSE(x1,...,xn)=log(exp(x1)+...+exp(xn))=c+lognexp(xic)c=max(x1,...,xn)

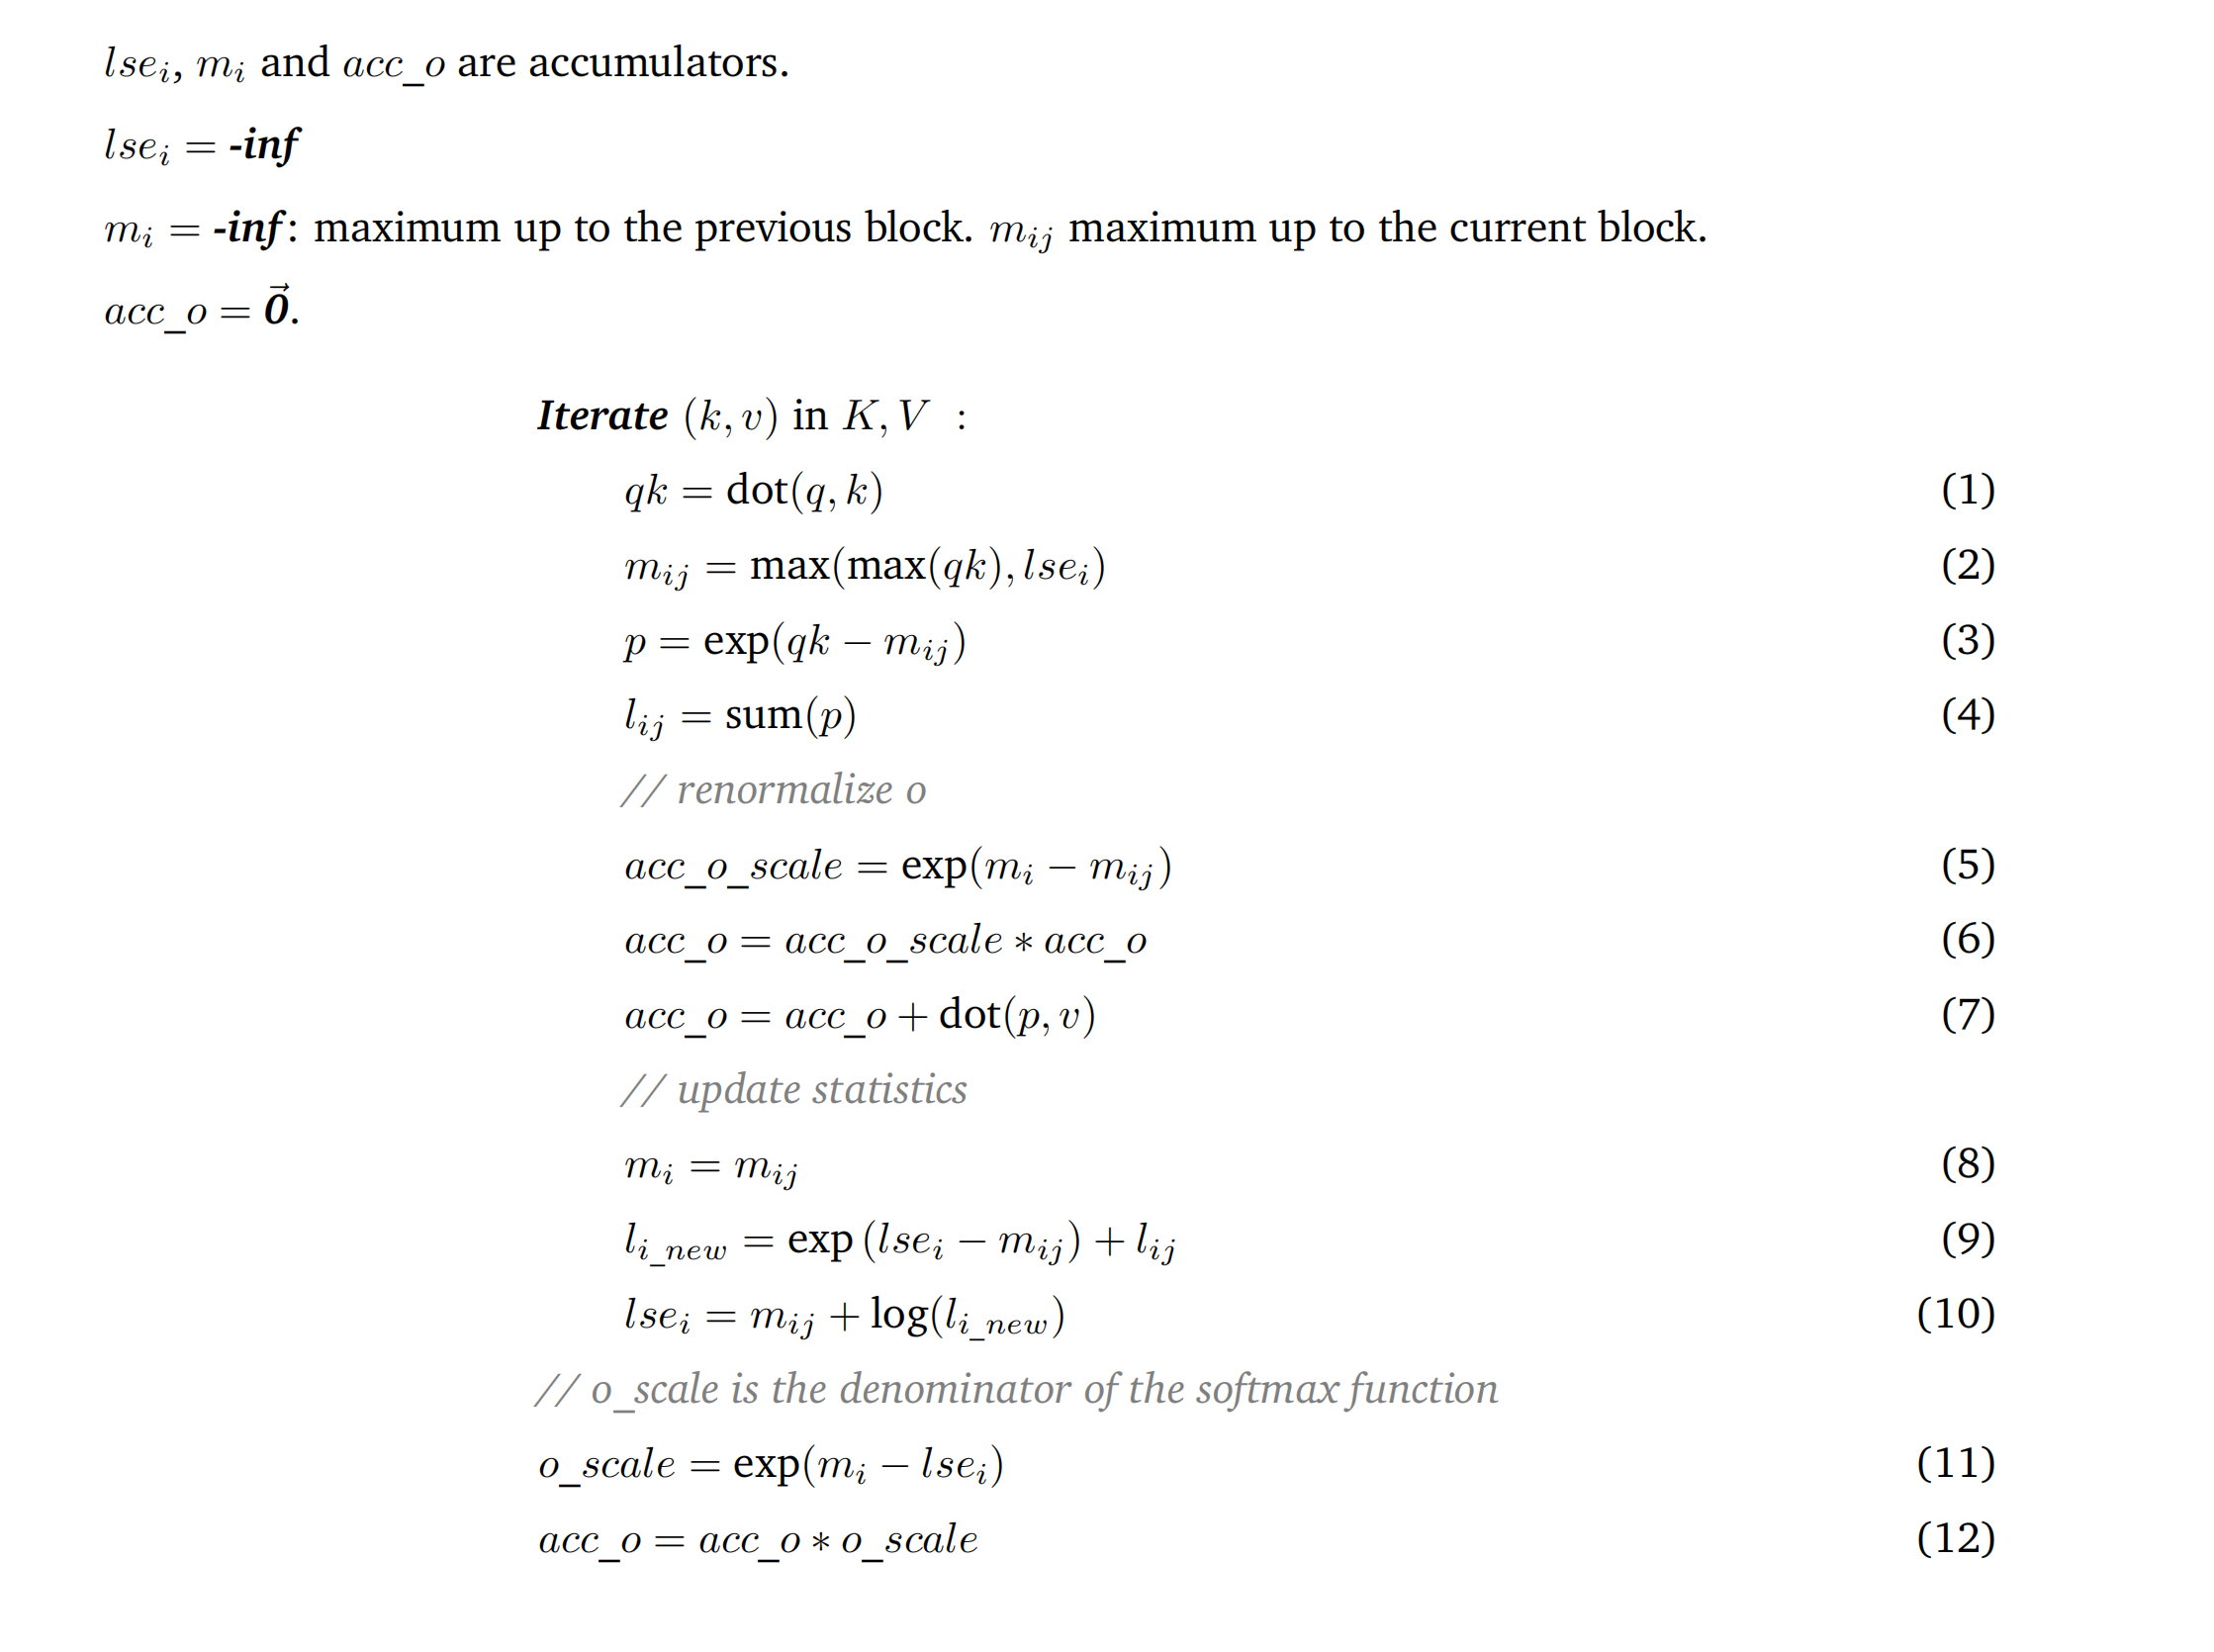
Triton 中的算法可以被描述为:

等式 (2)lse_i 被用于作为最大值的一个近似。

在等式 (9) 中:

exp(lseimij)=exp(cold+lognexp(xicold)cnew)+lij=exp((coldcnew+lognexp(xicold)))=exp(coldcnew)nexp(xicold)

在等式 (11) 中的 o_scale 作为 softmax 函数的分母:

milsei=exp(cclognexp(xic))=exp(lognexp(xic))=exp(log1nexp(xic))=1nexp(xic)

记录原理、连接知识、积累实践。