Linear Attention
传统的 Attention 因为 softmax 没办法先算右边的矩阵乘,所以整个复杂度变成了 O(
一般化定义为:
其中核函数可以表示为:
将 softamx 替换成核函数,Attention 可以被简化为:
Gated Linear Attention
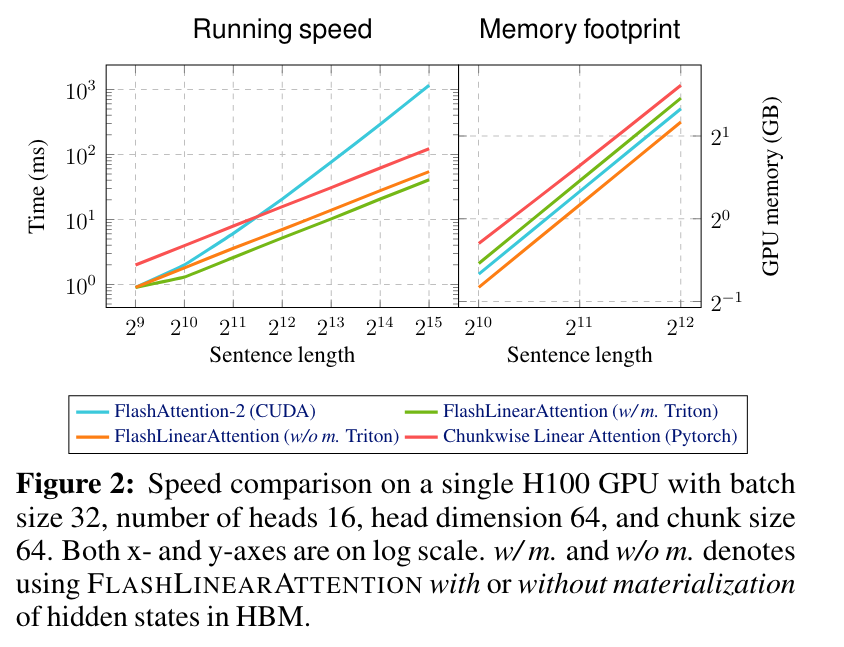
针对 Linear Attention 做硬件优化。
- Occupancy.
- Specialized compute units.
- Memory hierarchy.
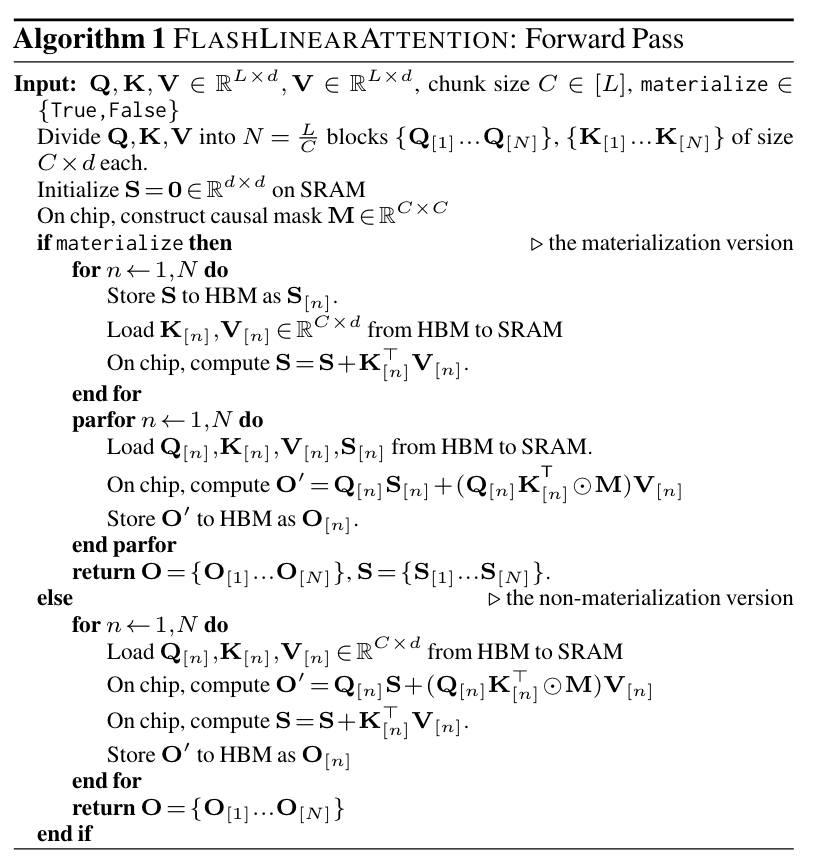
Flash Linear Attention 算法有一个 materialize 参数来控制是否要冲计算 S,无论是否要重计算 S 都要分块加载 Q, K, V 到共享内存中,然后可以重用共享内存上的块状 Tensor 来避免多次加载 HBM。
当 materialize 为 True 时,当
当 materialize 为 False 时,算法首先在 HBM 中把块间递归的结果存下来,然后将所有
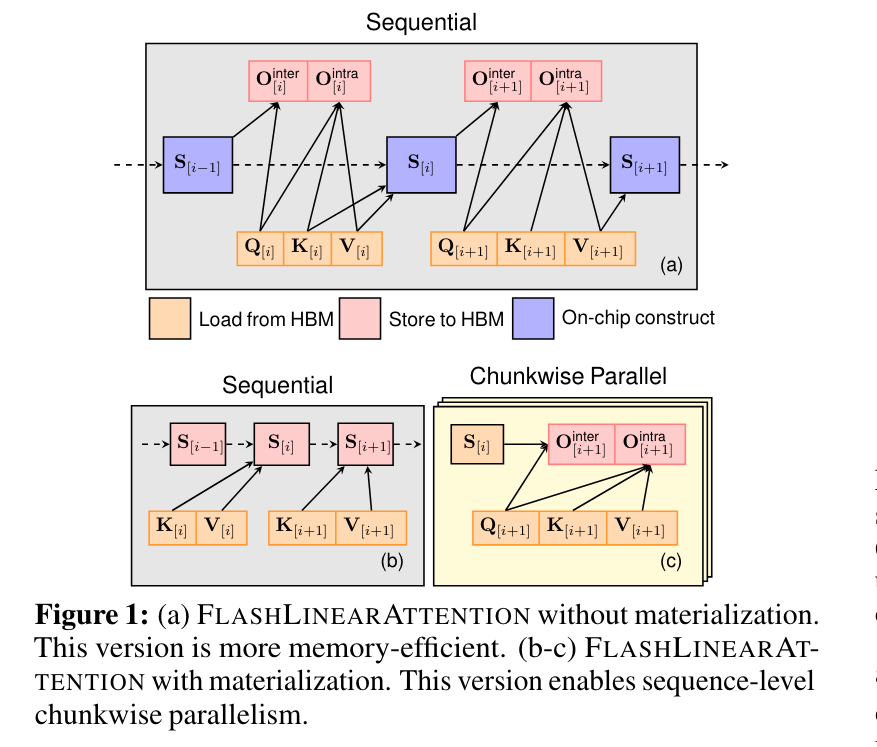
materialize 为 False 的情况下,Q,K,V 都是从 HBM 加载到 SRAM 上,每次会计算出一个新的隐藏状态 S,S 一直存储在 SRAM 上面,整体计算是串行的。对于 materialize 为 True 的情况,首先计算 KV 酸楚 S 并将 S 保存到 HBM 上,这部分是串行的,计算玩 S 后可以通过 CHunk 并行计算出
方程 (1) 中的线性递归没有衰减门或者遗忘门,在 RNN 中缺少衰减项使得模型难以“忘记”信息,这被假设为部分导致线性注意力在长上下文任务中不稳定的原因。最近的研究(RetNet)通过加入一个全局的、与数据无关的衰减因子
GLA 的递归和并行形式
递归形式
GLA 有一个二维遗忘门
其中使用外积来获得
其中
并行形式
将 (3) 展开可以得到:
设
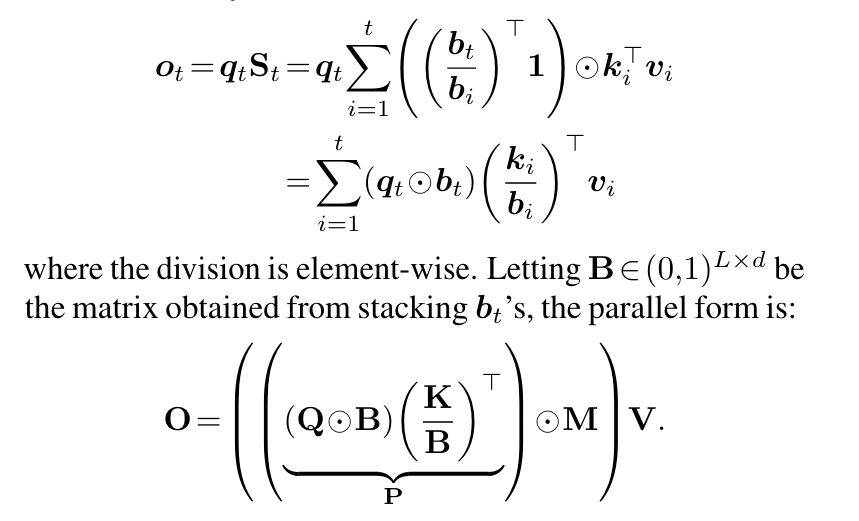
但是这种形式在数值上是不稳定的,因为
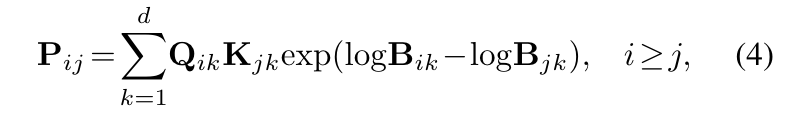
GLA 的 Chunkwise 形式
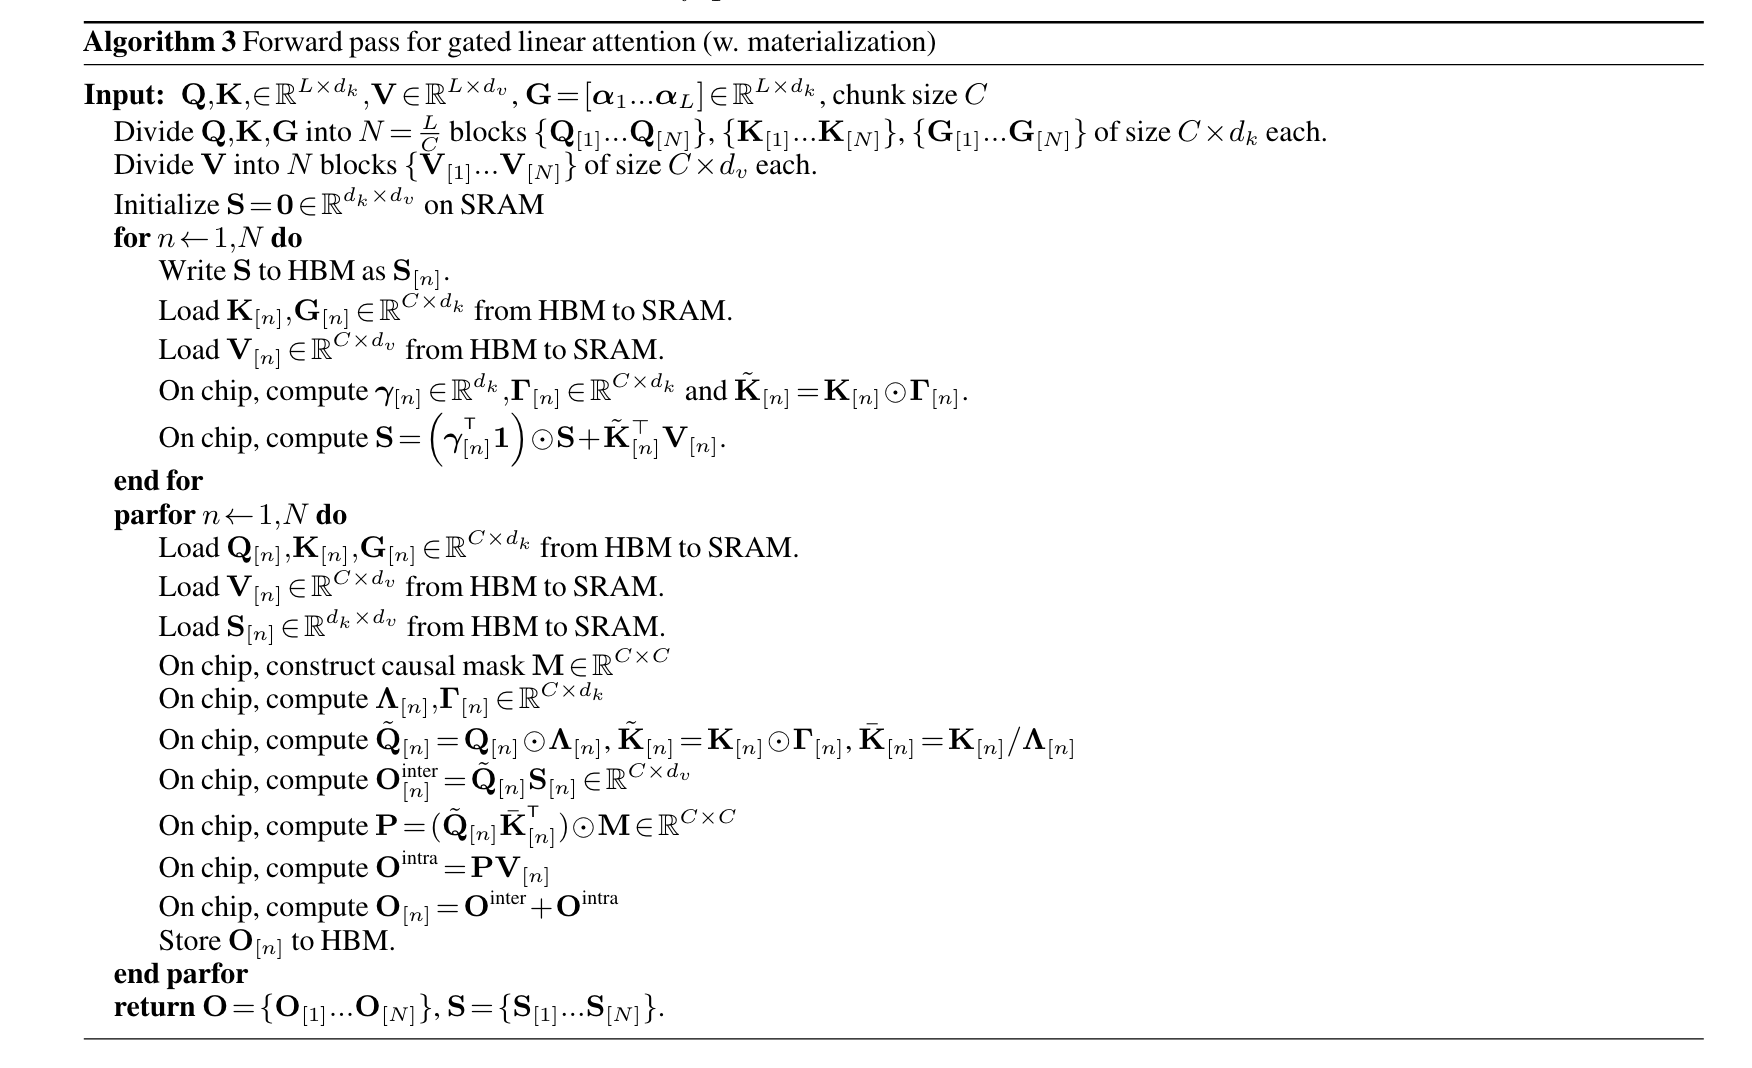
上面推导了与线性注意力中的 chunkwise 形式类似的 GLA chunkwise 形式。对于块内
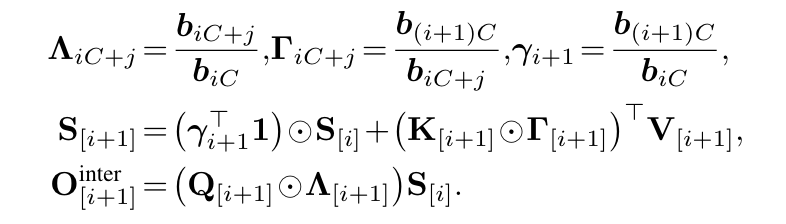
直观地说,
Hardware-Efficient GLA
Secondary-level Chunking
与普通线性注意力不同,GLA 中的块内计算无法使用 Tensor Core,因为涉及到对数运算(公式(4))。为了更好地利用 Tensor Core,采用次级级别 Chunk 化方案,即一个块进一步划分为子块,然后以块状方式计算类似注意力的矩阵
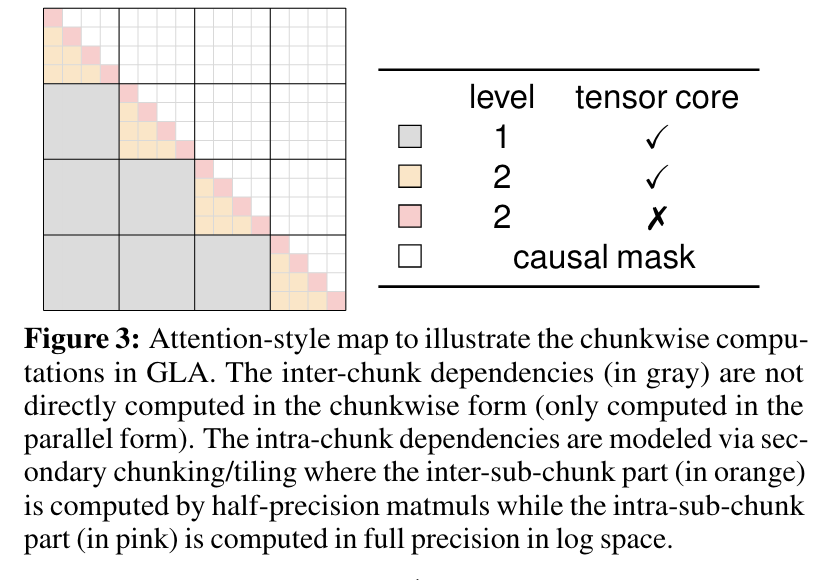
子块之间的交互是通过半精度矩阵乘法计算的:
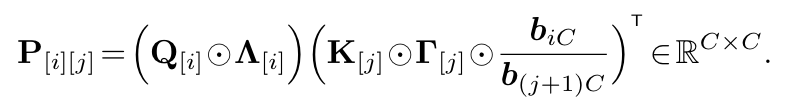
以上是对应于图 3 的橙色线条,对于块内子块部分(粉红色块),必须使用公式 (4) 并以全精度执行矩阵乘以确保稳定性。通过两级块化策略,非半精度矩阵乘法 FLOPs 总量大大减少。
Memory-efficient
过去的工作生成 GLA 模型必须将大小为
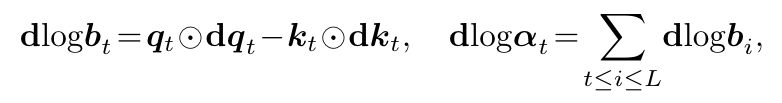
在附录中给出了 GLA 的伪代码:
def gated_linear_attention_forward(Q, K, V, a, C, c):
    '''
    Q/K/V: query/key/value
    a: log forget gate
    C/c: chunk size , subchunk size
    '''
    # L: sequence length , d: head dimension
    L, d_k = Q.shape
    d_v = V.shape[-1]

    S = torch.zeros(d_k, d_v)
    O = torch.empty_like(V)

    # cumsum of log decay within a chunk
    B = torch.empty_like(a)  # local compute of cumulative product of decay within a chunk

    for i in range(0, L // C):
        b = torch.zeros(d_k)
        for j in range(0, C):
            b += a[i]
        B[i] = b

    for i in range(0, L // C):
        r = range(i * C, (i + 1) * C)  # (C, d) chunking
        bq, bk, bv, bb = Q[r], K[r], V[r], B[r]
        b = bb[-1, None]  # inter-chunk w/ matmul

        q, k, g = bq * (bb.exp()), bk * ((b - bb).exp()), b.exp()
        o = q @ S  # hidden state update
        S = g.t() * S + k.t() @ bv

        # intra-chunk (secondary chunking)
        for j in range(0, C // c):
            t = range(j * c, (j + 1) * c)  # (c, head_dim) subchunking
            q, k, v, b = bq[t], bk[t], bv[t], bb[t]
            p = torch.zeros(c, c)  # intra-subchunk w/o matmul

            for m in range(c):
                for n in range(m + 1):
                    p[m, n] = torch.sum(q[m] * k[n] * ((b[m] - b[n]).exp()))

            o[t] += p @ v  # inter-subchunk w/ matmul

            z = b[0, None]
            q = q * (b - z).exp()

            for u in range(0, j):
                y = range(u * c, (u + 1) * c)
                p = q @ (bk[y] * (z - bb[y]).exp()).t()
                o[t] += p @ bv[y]

        O[r] = o
    return O