nnfusion 源码阅读
首先进入 tools/nnfusion/nnfusion.cpp 进入 main 函数开始执行,以 tensorflow、CUDA_GPU 为例进行解析:
nnfusion::frontend::load_tensor_model()用来加载 tensorflow 模型并将其转化成图。若编译器后端非空,则执行
cuda_engine.run_on_graph(graph),其中cuda_engine为建立的的空的CudaEngineObject。
Frontend(数据流图生成)
以 tensorflow 为例,首先查看 frontend/tensorflow_import/tensorflow.cpp,在该文件中定义了 load_tensorflow_model() 函数并调用了 GraphConvert 将模型转换成数据流图:
            GraphConvert::GraphConvert(const tensorflow::GraphDef& proto)
                : tf_graph_proto{&proto}
            {
                NNFUSION_LOG(INFO) << "Converting Tensorflow Graph";

                m_graph = std::make_shared<nnfusion::graph::Graph>();

                generate_topology();

                std::vector<InputInfo> inputs;
                while (!tf_topology_.empty())
                {
                    uint32_t node_idx = tf_topology_.front();
                    tf_topology_.pop();
                    inputs.clear();
                    const auto& node_proto = proto.node(node_idx);
                    bool in_control_dependence = false;
                    for (auto& input : node_proto.input())
                    {
                        TensorId input_tensor(ParseTensorName(input));
                        int src_index = input_tensor.second;

                        std::shared_ptr<nnfusion::graph::GNode> src_node;

                        auto iter = m_node_map.find(input_tensor.first);
                        NNFUSION_CHECK(iter != m_node_map.end())
                            << "Node " << node_proto.name()
                            << " has Un-Converted input node: " << input_tensor.first;
                        if (src_index == nnfusion::graph::Graph::kControlSlot)
                        {
                            in_control_dependence = true;
                            if (iter->second.size() > 0)
                            {
                                src_node = iter->second.at(0);
                                inputs.emplace_back(input_tensor.first, src_node, -1);
                            }
                        }
                        else
                        {
                            NNFUSION_CHECK(!in_control_dependence)
                                << "Control dependencies must come after regular "
                                   "dependencies.";
                            src_node = iter->second.at(src_index);
                            inputs.emplace_back(input_tensor.first, src_node, 0);
                        }
                    }

                    auto results = convert_node(node_proto);
                    m_node_map[node_proto.name()] = {};
                    for (auto& name_gnode_pair : results)
                    {
                        auto gnode = name_gnode_pair.second;
                        m_node_map[name_gnode_pair.first].push_back(gnode);

                        // add control edge
                        for (size_t input_idx = 0; input_idx < inputs.size(); input_idx++)
                        {
                            NNFUSION_CHECK_NOT_NULLPTR(inputs[input_idx].node)
                                << "Back edge is not supported now.";

                            if (inputs[input_idx].index == nnfusion::graph::Graph::kControlSlot)
                            {
                                m_graph->add_control_edge(inputs[input_idx].node, gnode);
                            }
                            else
                            {
                                // normal edge, do nothing
                            }
                        }
                        if (gnode->get_name() != name_gnode_pair.first)
                        {
                            //NNFUSION_CHECK(!(*gnode)["Alias"].is_valid())
                            //    << "node " << gnode->get_name() << " has more than one alias.\nThe tensorflow node is : \n" << node_proto.DebugString();
                            (*gnode)["Alias"] = name_gnode_pair.first;
                        }

                        if (tf_output_name_.find(node_proto.name()) != tf_output_name_.end())
                        {
                            m_graph_outputs.emplace_back(gnode);
                        }
                    }

                    for (size_t i = 0; i < tf_node_outputs_[node_idx].size(); ++i)
                    {
                        const int output = tf_node_outputs_[node_idx][i];
                        tf_pending_counts_[output]--;
                        if (tf_pending_counts_[output] == 0)
                        {
                            tf_topology_.push(output);
                        }
                    }
                }

                m_graph->set_outputs(m_graph_outputs);
                m_graph->set_default_parameters();
                NNFUSION_LOG(INFO) << "convert graph done";
}代码逻辑如下:
创建
GraphConvert类的构造函数,该类用于将TensorFlow的GraphDef(计算图的协议缓冲区表示)转换为nnfusion的图。初始化一些成员变量,包括指向TensorFlow GraphDef的指针
tf_graph_proto,以及用于存储nnfusion图和其他信息的成员变量。调用
generate_topology()函数,生成TensorFlow图的拓扑排序。进入主循环,从TensorFlow的拓扑排序队列
tf_topology_中依次取出节点。对于当前节点,解析其输入和依赖节点,并生成
InputInfo的向量inputs,每个InputInfo包含输入张量的名字、源节点以及输入索引。调用
convert_node(node_proto)函数,将当前TensorFlow节点转换为nnfusion节点。该函数将会返回一个由新的nnfusion节点组成的映射表,其中键是新节点的名字,值是新节点的指针。更新节点映射表
m_node_map,将新生成的nnfusion节点添加到映射表中,并将新节点与输入节点之间建立边关系。根据输入的索引,如果是控制依赖关系,则添加控制边,否则添加数据依赖边。如果新节点的名字与TensorFlow节点的名字不同,将新节点的名字设置为节点的别名。这通常是因为TensorFlow节点的名字可能包含特殊字符,不适合作为nnfusion节点的名字。
如果当前TensorFlow节点是输出节点,将其对应的nnfusion节点添加到图的输出节点列表
m_graph_outputs中。对于当前节点的输出,更新其在待处理节点计数数组
tf_pending_counts_中的计数,并根据计数是否为零,决定是否将其添加到下一轮的处理队列中。循环直至处理完所有节点,最后设置nnfusion图的输出节点并设置默认参数,完成TensorFlow到nnfusion的图转换。
generate_topology:
generate_topology() 的函数,用于生成 TensorFlow 模型的拓扑结构信息。以下是对这个函数的解析:
首先,获取 TensorFlow 模型中节点的数量
num_nodes。创建一个无序映射
tensorflow_name2nodeIdx_map,用于将 TensorFlow 节点的名称映射到其索引。第一个循环遍历所有节点,将节点的名称和索引存储到
tensorflow_name2nodeIdx_map中,以便在后续步骤中进行查找。为每个节点计算输入依赖关系。对于每个节点,统计其输入数量,并将每个输入节点的输出指向当前节点。这样,可以建立一个以节点索引为键,输入节点索引数组为值的
tf_node_outputs_数据结构,用于表示每个节点的输出节点索引。同时,初始化每个节点的待处理计数为其输入数量,并将待处理计数存储在
tf_pending_counts_中。对于每个节点,如果其待处理计数为 0,表示该节点没有任何输入依赖,将其索引推入
tf_topology_中,以准备后续处理。最后,遍历所有节点,如果某个节点的输出节点列表为空,说明它是计算图的输出节点,将其名称添加到
tf_output_name_集合中。
总之,generate_topology() 函数通过遍历 TensorFlow 模型的节点,并分析其输入依赖关系,生成了模型的拓扑结构信息。这个信息将在模型转换的过程中用于处理节点的顺序以及构建边。
计算图
在 src/nnfusion/core/graph/graph.hpp 中定义了 Graph 数据结构的成员变量:
        private:
            // Map from node ids to allocated nodes.  nodes_[id] may be nullptr if
            // the node with that id was removed from the graph.
            GNodeVector m_nodes;

            //ordered ops from bfs
            GNodeVector m_bfs_ordered_ops;
            bool m_bfs_ordered_ops_is_valid = false;

            // Number of nodes alive.
            size_t m_node_size = 0;

            // Map from edge ids to allocated edges.  m_edges[id] may be nullptr if
            // the edge with that id was removed from the graph.
            std::vector<std::shared_ptr<Edge>> m_edges;

            // The number of entries in m_edges that are not nullptr.
            size_t m_edge_size = 0;

            // Allocated but free nodes and edges.
            GNodeVector m_free_nodes;
            std::vector<std::shared_ptr<Edge>> m_free_edges;

            // TODO: Output nodes of this graph
            GNodeVector m_output_nodes;
            GNodeVector m_parameters;
            // For generating unique names.
            int name_counter_ = 0;

            static std::atomic<size_t> m_next_instance_id;
            size_t m_instance_id;
            std::string m_name;
            const std::string m_unique_name;

size_t m_temporary_pool_size;在这个数据结构中有几个重要的成员变量:
m_nodes: 包含了所有节点
m_edges: 包含了所有边
m_free_nodes:用于分配但已经回收了的节点,避免频繁内存分配
m_output_nodes:图的输出节点
同时,该数据结构也有很多方法,例如向图中添加节点和边:
void Graph::add_gnode_and_edge(const std::shared_ptr<GNode> gnode,
                               const GNodeIndexVector& input_gnodes)
{
    NNFUSION_CHECK(gnode == nullptr) << "GNode can't be nullptr.";

    add_node(gnode);

    for (size_t i = 0; i < input_gnodes.size(); i++)
    {
        add_edge(input_gnodes[i].gnode, input_gnodes[i].index, gnode, i);
    }
    gnode->get_op_ptr()->revalidate_and_infer_types(gnode->shared_from_this());
}接下来看 src/nnfusion/core/graph/gnode.hpp 中定义了图中节点:
        protected:
            int64_t m_id; // m_id is for graph, the index in graph m_nodes
            size_t m_instance_id;
            static std::atomic<size_t> m_next_instance_id;
            std::string m_name;
            const std::string m_unique_name;

            std::string m_op_type;
            std::shared_ptr<op::Op> m_op_ptr;

            std::set<std::shared_ptr<Edge>> m_in_edges;
            std::set<std::shared_ptr<Edge>> m_out_edges;

            std::vector<std::shared_ptr<Input>> m_inputs;
std::vector<std::shared_ptr<Output>> m_outputs;这里需要关注的几个成员变量:
m_in_edges:入边m_out_edges: 出边m_inputs: 输入m_outputs: 输出m_op_type: 算子类型m_op_ptr:算子指针
Op 数据类型是一个算子基类,Input 表示输入数据,Input 中分别有两个 field,m_shape 和 m_partial_shape 分别用于静态图和动态图。Output 有一个 m_tensor 的 field,是使用 Tensor 类型所描述的。
Tensor
Tensor 类型定义在 src/nnfusion/common/descriptor/tensor.hpp 中,以下是 Tensor 的主要成员和功能:
构造函数:构造函数用于创建一个张量描述。它接受以下参数:
element_type:表示张量的元素类型,例如 float32、int64 等。pshape:表示张量的部分形状(可能是静态形状或动态形状)。name:表示张量的名称。device_type:表示张量所在的设备类型,例如 CPU、GPU 等。is_persistent:表示张量是否是持久性张量。is_constant:表示张量是否是常量张量。is_parameter:表示张量是否是参数张量。is_RDMA_tensor:表示张量是否是远程内存访问(RDMA)张量。group:表示张量所属的分组。device_id:表示张量所在的设备 ID。
其他成员函数:
get_name和set_name:获取和设置张量的名称。get_element_type:获取张量的元素类型。get_shape和get_partial_shape:分别获取张量的静态形状和部分形状。get_tensor_layout和set_tensor_layout:获取和设置张量的布局信息。set_pool_offset和get_pool_offset:设置和获取张量在内存池中的偏移量。set_pool和get_pool:设置和获取张量所属的内存池。initialized:检查张量是否已初始化。is_same_address:检查两个张量是否指向相同的内存地址。size:计算张量的大小(元素数量)。set_root_tensor和get_root_tensor:设置和获取张量的根张量。ref和deref:增加和减少对张量的引用计数。is_persistent、is_constant、is_parameter、is_RDMA_tensor:判断张量的类型。set_group和get_group:设置和获取张量的分组信息。set_device_type和get_device_type:设置和获取张量的设备类型。set_device_id和get_device_id:设置和获取张量的设备 ID。get_device_name:获取张量所在设备的名称。get_unique_name:获取张量的唯一名称。
静态成员变量:
m_next_instance_id:静态原子变量,用于生成张量实例的唯一标识。
TensorLayout
src/nnfusion/common/descriptor/layout/tensor_layout.hpp 文件定义了一个名为 TensorLayout 的抽象基类,用于描述张量视图的布局信息。张量视图布局描述了如何将张量的多维数据映射到内存中,以支持张量的不同形状和布局。
以下是 TensorLayout 类的主要成员和功能:
构造函数:构造函数接受一个
nnfusion::descriptor::Tensor对象,用于初始化布局信息。成员函数:
get_size:获取视图在缓冲区中的大小(字节数)。get_allocated_size:获取已分配内存的大小。get_index_offset:根据给定索引返回对应的偏移量,用于支持切片操作。get_element_type:获取视图中元素的数据类型。get_shape:获取视图的形状。get_strides:获取视图中各个维度的步幅。operator==:判断两个视图布局是否相同。
其他细节:
TensorLayout类为抽象基类,它定义了一个接口,但没有提供具体实现。具体的张量布局实现应该从这个基类派生,并实现纯虚函数。
DenseTensorLayout
src/nnfusion/common/descriptor/layout/dense_tensor_layout.hpp 文件定义了一个名为 DenseTensorLayout 的类,该类表示标准的分块布局,用于支持行主序(row-major)、列主序(column-major)以及它们的排列和切片。
以下是 DenseTensorLayout 类的主要成员和功能:
构造函数:构造函数接受一个
nnfusion::descriptor::Tensor对象,并在基类构造函数的基础上初始化布局信息。成员函数:
get_offset:获取偏移量,用于标识张量数据在内存中的起始位置。get_index_offset:根据给定索引返回对应的偏移量,以支持切片操作。get_strides:获取各个维度的步幅,用于计算不同维度之间的距离。operator==:判断两个布局是否相同。
DenseTensorLayout 类继承自抽象基类 TensorLayout,它表示标准的分块布局,适用于支持常见的张量形状和布局,如行主序和列主序。通过实现不同类型的布局,深度学习框架可以在不同计算设备上优化内存访问,从而提高计算性能。
Engine
观察 CudaEngine 发现其是 Engine 的子类,Engine 有以下几个私有变量:
InterpreterPassManager::Pointer m_passesGraphPassManager::Pointer g_passesGraphVisitor::Pointer g_visitor
观察 Engine::run_on_graph(graph::Graph::Pointer graph, EngineContext::Pointer context) 的实现,发现分别执行以下三个函数:
g_passes->run_on_graph(graph, context)g_visitor->run_on_graph(graph, context)g_visitor->run_on_graph(graph, context)
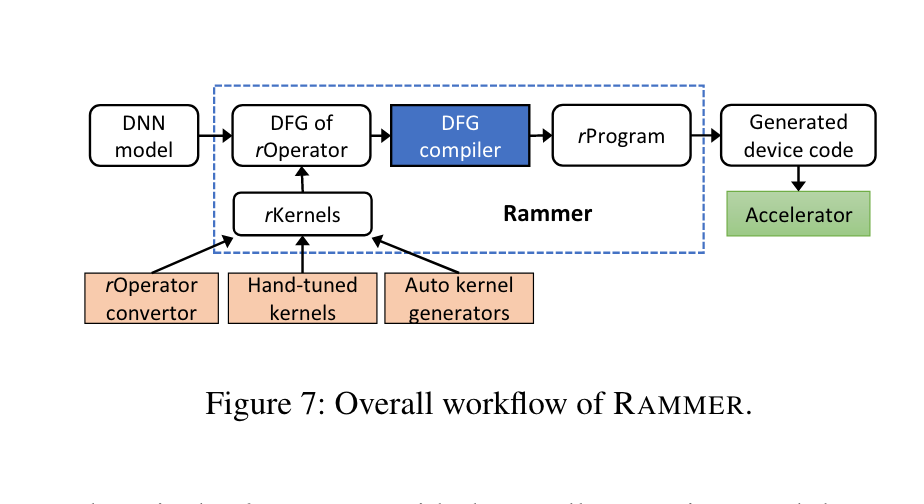
基于上图不难推断:
g_passes->run_on_graph(graph, context)用于将算子数据流图转成 rOperator 的数据流图g_visitor->run_on_graph(graph, context)用于将 rOperator 的数据流图转成 rProgramg_visitor->run_on_graph(graph, context)用于将 rProgram 转换成设备可运行的代码
rOperation 生成
观察 GraphPassManager::Pointer 是一个继承自vector<shared_ptr<nnfusion::pass::graph::GraphPassBase>> 的类,有一个 run_on_graph 的方法。
观察 GraphPassBase 发现其是一个基类,里面没有任何私有数据。考虑到 CudaEngine 在初始化时向 g_passes push 了很多派生类:
CudaEngine::CudaEngine()
    : Engine()
{
    g_passes->push_back(make_shared<CSEPass>());
    g_passes->push_back(make_shared<AutodiffPass>());
    g_passes->push_back(make_shared<GradientWeightMappingPass>());
    g_passes->push_back(make_shared<RuntimeConstantFoldingPass>());
    g_passes->push_back(make_shared<MultiReshapeFoldingPass>());
    g_passes->push_back(make_shared<VectorDotTransposePass>());
    g_passes->push_back(make_shared<GemmFusionPass>());
    g_passes->push_back(make_shared<BatchNormInferenceFoldingPass>());
    g_passes->push_back(make_shared<AssignLayoutPass>());
    g_passes->push_back(make_shared<OpInplacePass>());

    g_passes->push_back(make_shared<PatternSubstitutionPass>());

    // Kernel selection
    g_passes->push_back(make_shared<DefaultGNodeDeviceDispatcher>());
    g_passes->push_back(make_shared<ProfilingBasedKernelSelector>());
    g_passes->push_back(make_shared<FetchBasedSelector>());
    g_passes->push_back(make_shared<DefaultKernelSelector>());

    // GPU specific graph passes
    g_passes->push_back(make_shared<KernelFusionPass>());
    g_passes->push_back(make_shared<KernelProfilingPass>());
    g_passes->push_back(make_shared<PatternSubstitutionPass>());
    g_passes->push_back(make_shared<BlockFusionPass>());

    // Specific opt for dot
    g_passes->push_back(make_shared<DotTransposePass>());

    // Assign stream passes
    g_passes->push_back(make_shared<AssignAsyncInfoPass>());

    // Visitor
    g_visitor = make_shared<ReversedDFSVisitor>();

    // extract graph signature
    m_passes->push_back(make_shared<ExtractGraphSignature>());
    // Do tensor allocation plan
    m_passes->push_back(make_shared<TensorDeviceDispatcher>());
    m_passes->push_back(make_shared<TensorLivenessAnalysis>());
    m_passes->push_back(make_shared<InplaceTensorAnalysis>());
    m_passes->push_back(make_shared<AssignTensorMemoryLayout>(64, false));

    // Do codegen
    m_passes->push_back(make_shared<CudaCodegenPass>());
}在这个阶段主要完成从 DFG of Operator 到 DFG of rOperator 的转换,这里不改变 graph 的数据类型,主要主要通过替换 graph 中的 node 完成。
点入 CSEPass 查看,发现其中实现了 run_on_graph():
bool CSEPass::run_on_graph(std::shared_ptr<Graph>& graph)
{
    bool enable_cse = FLAGS_fcse;
    if (!enable_cse)
        return true;

    bool replaced = false;
    unordered_map<NodeKey, shared_ptr<GNode>> expressions{};

    for (auto n : graph->get_ordered_ops())
    {
        auto op = n->get_op_ptr();
        if (op->is_output() || op->is_parameter())
        {
            continue;
        }

        NodeKey n_key(n);
        if (expressions.count(n_key))
        {
            graph->replace_node(n, expressions.at(n_key), false);
            replaced = true;
        }
        else
        {
            expressions.insert(make_pair(n_key, n));
        }
    }
    return true;
}这是一个公共子表达式消除(Common Subexpression Elimination,CSE)的优化过程,如代码所示:
读取优化开关:首先,代码会读取全局标志
FLAGS_fcse,以确定是否启用公共子表达式消除优化。如果未启用,则函数直接返回true,不进行任何优化。初始化变量:创建一个用于存储表达式的
unordered_map,命名为expressions。该映射用于存储已经遍历的节点以及其对应的公共子表达式。遍历计算图节点:代码使用
graph->get_ordered_ops()遍历计算图中的每个节点(操作)。对于每个节点,执行以下操作:a. 检查节点类型:首先,代码检查当前节点是否是输出节点或参数节点。如果是,表示这些节点不是计算过程的一部分,因此跳过处理。
b. 创建节点键:通过
NodeKey类创建一个节点键n_key,用于标识当前节点的子表达式。c. 查找子表达式:检查
expressions映射中是否已经存在与n_key对应的节点。如果已经存在,说明这个子表达式已经出现过,可以被替换。d. 替换或存储子表达式:如果在
expressions中找到了相同的子表达式,那么当前节点可以被替换为之前存储的节点。使用graph->replace_node方法实现替换操作。如果没有找到相同的子表达式,就将当前节点插入到expressions中。返回结果:遍历结束后,函数返回
true,表示优化完成。
ProfilingBasedKernelSelector 是一个基于分析器用来选择内核算子的算法实现:
bool ProfilingBasedKernelSelector::run_on_graph(std::shared_ptr<nnfusion::graph::Graph>& graph)
{
    bool enable_tuning = FLAGS_fkernel_tunning;
    if (!enable_tuning)
        return true;

    // auto dev_name = FLAGS_fdefault_device.c_str();
    // NNFusion_DeviceType default_device = nnfusion::get_device_type(dev_name);

    // Config area
    vector<string> white_list{"Broadcast"};
    //bool all_device = false;
    NNFusion_DeviceType the_device = ROCM_GPU;

    // if (the_device != default_device)
    //     return true;

    // Currently *ONLY* has BroadCast Selection
    std::vector<std::shared_ptr<GNode>> nodes = graph->get_nodes();
    for (auto it : nodes)
    {
        if (!(*it)["DeviceType"].is_valid())
        {
            NNFUSION_CHECK_FAIL() << "GNode DeviceType should be assigned before this pass:"
                                  << it->get_name();
        }
        auto n_device_type = (*it)["DeviceType"].as<NNFusion_DeviceType>();
        NNFUSION_CHECK(n_device_type != UNKNOWN);
        if (n_device_type != the_device)
            continue;
        auto opname = it->get_op_type();
        for (auto& rule : white_list)
            if (opname == rule)
            {
                (*it)["Enable_Kernel_Selection"] = true;
                // if (!all_device)
                //     (*it)["Kernel_Selection_Device"] = the_device;
            }
    }

    for (auto it : nodes)
    {
        if ((*it)["Enable_Kernel_Selection"].is_valid() &&
            (*it)["Enable_Kernel_Selection"].as<bool>())
        {
            auto n_device_type = (*it)["DeviceType"].as<NNFusion_DeviceType>();
            auto ans = profiling_best(it, n_device_type, get_default_runtime(n_device_type));
            if (ans.second != nullptr)
                (*it)["Kernel_Selection_Result"] = ans;
            else
            {
                if (n_device_type == ROCM_GPU)
                {
                    auto ans_cuda = profiling_best(it, CUDA_GPU, get_default_runtime(CUDA_GPU));
                    if (ans_cuda.second != nullptr)
                        (*it)["Kernel_Selection_Result"] = ans_cuda;
                }
            }
        }
    }

    return true;
}算法的流程如下:
读取优化开关:首先,代码会读取全局标志
FLAGS_fkernel_tunning,以确定是否启用基于性能分析的内核选择优化。如果未启用,函数直接返回true,不进行任何优化。配置区域:代码定义了一个白名单
white_list,其中列出了需要进行内核选择的操作名称(Op name)。在此示例中,只有操作名为 "Broadcast" 的节点会进行内核选择。获取计算图中的节点:使用
graph->get_nodes()获取计算图中的所有节点,并将它们存储在nodes向量中。遍历节点进行内核选择:对于每个节点,执行以下操作:
检查节点的设备类型:检查当前节点的
DeviceType是否已被赋值。如果没有,表示在执行此优化之前应该为节点分配设备类型,否则会产生错误。如果设备类型有效,则继续下一步。检查设备类型匹配:检查节点的设备类型是否与预设的
the_device(在代码中为 ROCM_GPU)匹配。如果不匹配,表示该节点不在当前设备上进行内核选择,因此跳过此节点。匹配白名单:检查当前节点的操作类型(Op type)是否在白名单
white_list中。如果操作名在白名单中,表示该节点需要进行内核选择。将节点的Enable_Kernel_Selection属性设置为true,以标记需要进行内核选择的节点。
遍历进行实际的内核选择:再次遍历所有节点,对于标记为需要内核选择的节点,执行以下操作:
获取设备类型和运行时:获取节点的设备类型和默认的运行时(Runtime)实现。
进行性能分析:使用
profiling_best函数对当前节点进行性能分析,以找到最佳的内核实现。更新节点属性:如果找到了最佳内核实现,将其存储在节点的
Kernel_Selection_Result属性中。
返回结果:遍历结束后,函数返回
true,表示优化完成。
Profiler
TODO
rProgram 生成
在 cuda.cpp 中初始化 CudaEngine 的时候将 g_vistor 初始化了为 ReversedDFSVistor,在 ReversedDFSVistor 中实现了 run_on_graph 的方法:
nnfusion::ir::Program::Pointer ReversedDFSVisitor::run_on_graph(shared_ptr<graph::Graph> graph,
                                                                EngineContext::Pointer context)
{
    NNFUSION_LOG(INFO) << "Translating graph:\t" << graph->get_name();

    auto program =
        make_shared<ir::Program>(nnfusion::ir::Program::create_single_basic_block_program());
    auto bb_main = program->get_entry();

    // Translate the Node
    // Currently:
    // * Translate each gnode into an instruction;
    // * Store all instruction inside one basicblock since we don't have
    //   control-flow by now.
    nnfusion::graph::GNodeVector node_vec;
    if (FLAGS_fstream_assign_policy == "kernel_prof_based")
        node_vec = graph->get_bfs_ordered_ops();
    else
        node_vec = graph->get_ordered_ops();

    for (auto gnode : node_vec)
    {
        shared_ptr<TranslationUnit> _tu(new TranslationUnit());
        nnfusion::ir::Instruction::Pointer ir(new nnfusion::ir::Instruction);
        ir->setGNode(gnode);
        ir->copy_tags_from(*gnode);
        ir->setName(gnode->get_name());
        bb_main->push_back(ir);
        add_memcpy_ir(graph, gnode, bb_main);
    }

    return program;
}首先创建一个空的 program,并将图中的算子转换成算子节点的集合(在论文中称为 rTask),随后遍历节点集合。
这里的 Program 是一个 BasicBlock 的向量集合,而 BasicBlock 又是 Instruction 的向量集合,而 Instruction 是一个简单包裹的类型,有 gnode、kernel、inputs,outputs,internal_tensors 等属性,其中 kernel 是一个 KernelEmitter 类型,可以对一个操作符生成特殊的计算 kernel,也就是论文中提到的 rKernels。因此 Instruction 可以看成是一个 rTask 也就是可以执行的最小单元。
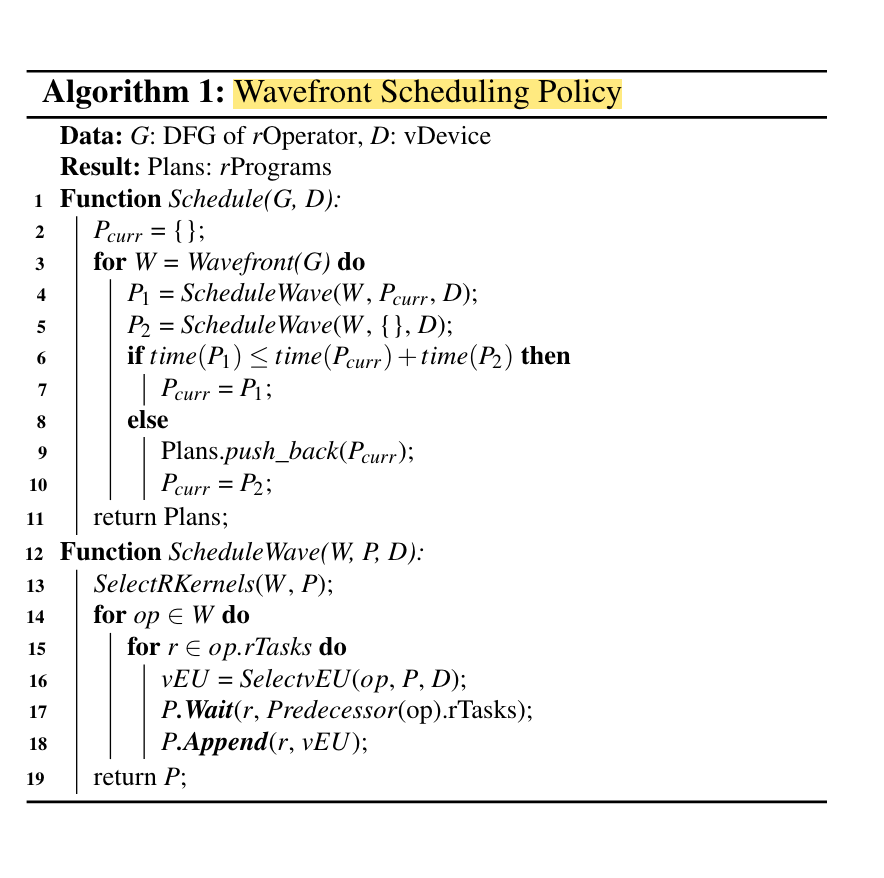
在遍历节点集合过程中的重点是 add_memcpy_ir(graph, gnode, bb_main) 的调用:
首先根据不同的类型创建不同的
AsyncManagerFactor随后遍历该节点的所有出边,若出边不是自己的话,也即是从该节点到下一个节点有数据流通过,创建一个
memcpy_ir,也即在中间插入一个内存拷贝的指令。随后将 memcpy_ir 的输入 tensor 修改为出边节点的输入 tensor, 将输出 tensor 设置为新建的 tensor。随后检查
memcpy_ir和输出节点的execution_thread是否为一个,若不相同的话则添加等待队列和屏障。最终将
memory_ir加到 bb_main 这个 BasicBlock 中(这里有个问题,为何只创建了单个 BasicBlock,按照论文描述,应该是 rProgram 直接包含 rTask,代码里是:Program(BasicBlock(Instruction))
AsyncManagerFactor
TODO
代码生成
生成 program 后,调用 m_passes->run_on_program(p, context) 用来进行代码生成,检查 run_on_program() 函数:
首先初始化
_tu(翻译单元,暂时不知道做什么的)和ctx遍历所有 pass 进行运行
检查 nnfusion/engine/device/cuda.cpp,发现 CudaEngine 在初始化时添加了如下的 pass:
    // extract graph signature
    m_passes->push_back(make_shared<ExtractGraphSignature>());
    // Do tensor allocation plan
    m_passes->push_back(make_shared<TensorDeviceDispatcher>());
    m_passes->push_back(make_shared<TensorLivenessAnalysis>());
    m_passes->push_back(make_shared<InplaceTensorAnalysis>());
    m_passes->push_back(make_shared<AssignTensorMemoryLayout>(64, false));

    // Do codegen
m_passes->push_back(make_shared<CudaCodegenPass>());因此,代码生成部分会依次遍历以上所有 pass 并执行 run() 方法。
例如在这里的 ExtractGraphSignature 类型中的 run() 方法将提取图中的符号并将其写入 json 文件。
在 CudaCodegenPass 中会调用 engine/pass/codegen/codegenerator.cpp 文件中的 codegen(),该函数用于最终的代码生成,该函数的流程如下:
codegen() 函数是 CodeGenerator 类中的一个方法,用于实际执行代码生成的过程。这个函数的主要任务是根据生成的代码单元(LanguageUnit)对象,将生成的代码写入文件中。下面是 codegen() 函数的流程:
准备阶段:首先,函数会调用
pass_exec_info()方法,这个方法用于在代码生成单元之间传递执行信息,比如生成文件的目录和写入位置。这个阶段确保每个代码生成单元都有执行的位置和目录信息。排序代码单元:接下来,函数会对所有的代码生成单元进行排序,以便确定代码的生成顺序。排序的顺序是根据代码生成单元的类型和执行优先级。
写入代码:通过对排序后的代码生成单元进行迭代,函数会逐个执行这些单元的
execute()方法,将生成的代码写入到对应的文件中。创建文件:在写入代码之前,函数会首先判断文件是否存在,如果不存在就创建文件。根据单元中的
pwd(文件路径)和write_to(文件名)信息,函数会确保生成文件的目录结构存在。共享文件处理:如果在单元中指定了共享文件(
write_to为shared开头),函数会创建一个名为 "shared.h" 的共享文件,并将相关的代码引用添加到生成的代码文件中。