DeepSeek-V3.2 与 DSA:年度总结摘记
来源:个人文章全文归档。
整理与复习
- 详细流程见 DSA 算法笔记。
- 主 Attention 只读入选位置,不等于永久删除未入选的 KV;后续 query 仍可能选择它们。
- 固定预算使主 Attention 的访问量下降;不能据此断言包含全历史 indexer 打分的端到端复杂度也严格变为线性。
- “Lighting”应为“Lightning”;旧文章的投影来源描述应以实际模型和上述独立笔记为准。
原笔记相关章节
DeepSeek-V3.2
DeepSeek-V3.2 主要创新性在于提出了 DSA(DeepSeek Sparse Attention),DSA 是一种可以在训练中学习的稀疏注意力算法,相比原有的固定模式的稀疏注意力,可以在训练中被使用。
DeepSeek Sparse Attention
DSA 包含两个组件,一个闪电索引器(lighting indexer)和一个细粒度词元选择器(fine-grained token selection mechanism)。
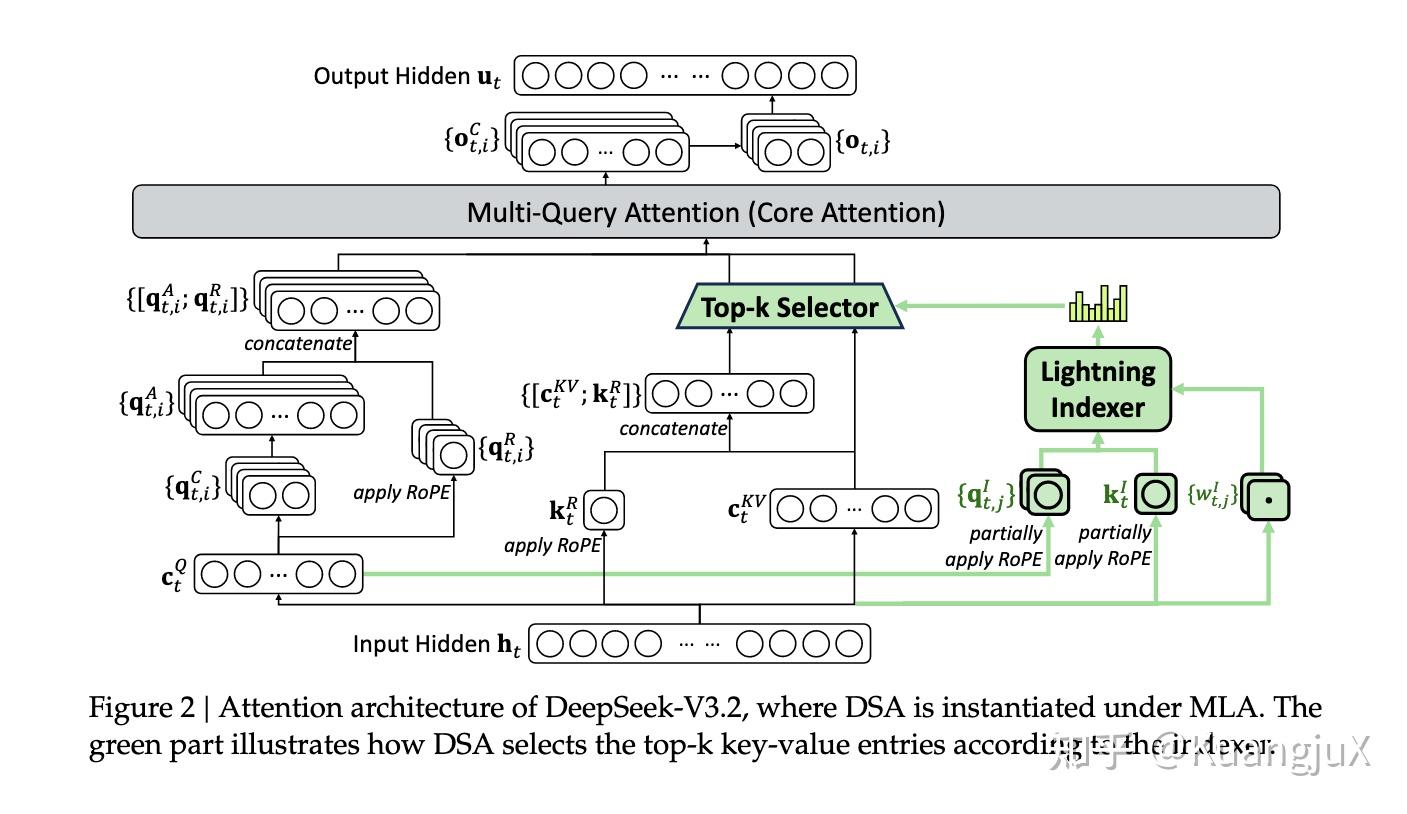
DeepSeek Sparse Attention 架构图
首先针对 Lighting Indexer,DeepSeek 给出了一个数学公式如下:
:索引器的头数,数量较少,是保证效率的关键; :当前的 query token 向量, :前置的 token 向量; 、 :由 query token 生成的查询向量和权重; :由前置 token 生成的键向量; :作为激活函数,选择它的核心原因是提升计算吞吐量。
在 DSA 中,首先通过输入的
- 从
中部分投影得到 (对应论文的 ); - 从所有前置 token 的
(MLA 的 latent key-value 向量)中部分投影得到 (对应论文的 ); - 从
中投影得到 (对应论文的 ); - 对
和 部分施加 RoPE 位置编码,再计算内积 + ReLU + 加权求和,得到索引分数(图中 “柱状图” 是分数的可视化)。
最终得到的计算分数
这里有几个值得注意的点,这里的
第二步是做 Token 的细粒度选择,在论文中给出了一个公式:
通过这一机制,DSA 将注意力就按的复杂度从