FLASHATTENTION: Fast and Memory-Efficient Exact Attention with IO-Awareness:历史笔记
易错概念
旧笔记 L9 的 O_i K_j^T 是变量笔误:分块分数应由 Q_i K_j^T 得到。可对照下方 Algorithm 1 原截图。原笔记开头的标准注意力公式省略了缩放因子,不能与完整 scaled dot-product attention 的定义混同;访存瓶颈结论也需结合其硬件与问题规模理解。
相关基础笔记:FlashAttention 的 online softmax 与版本演进。
历史阅读笔记
原笔记参考:知乎文章。
首先需要明确 Self-Attention 的计算过程: 三个矩阵
(1) (2) (3)
Self-Attention 中(1) 和 (3) 的计算最密集,(1) 和 (3) 中的矩阵乘法复杂度为
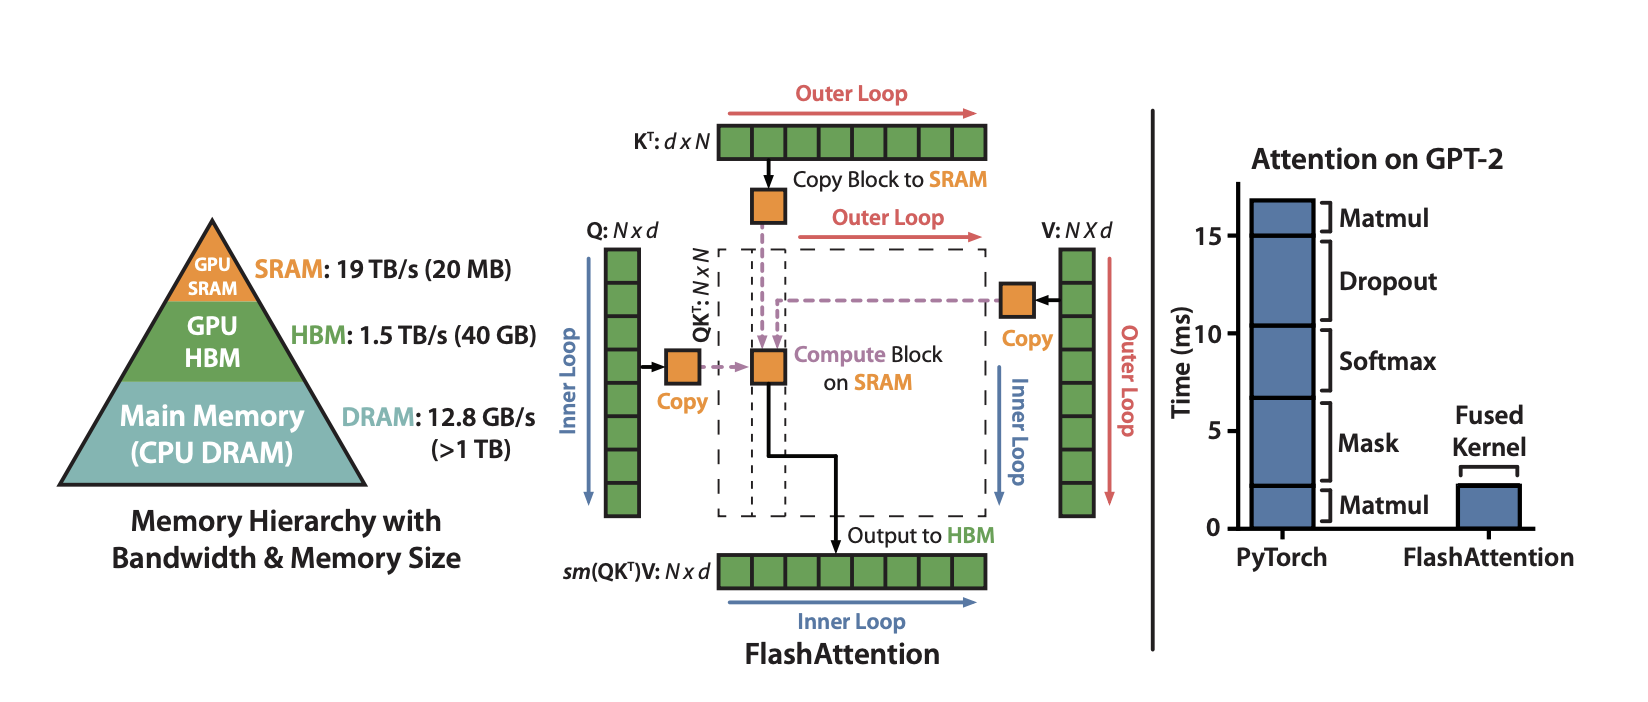
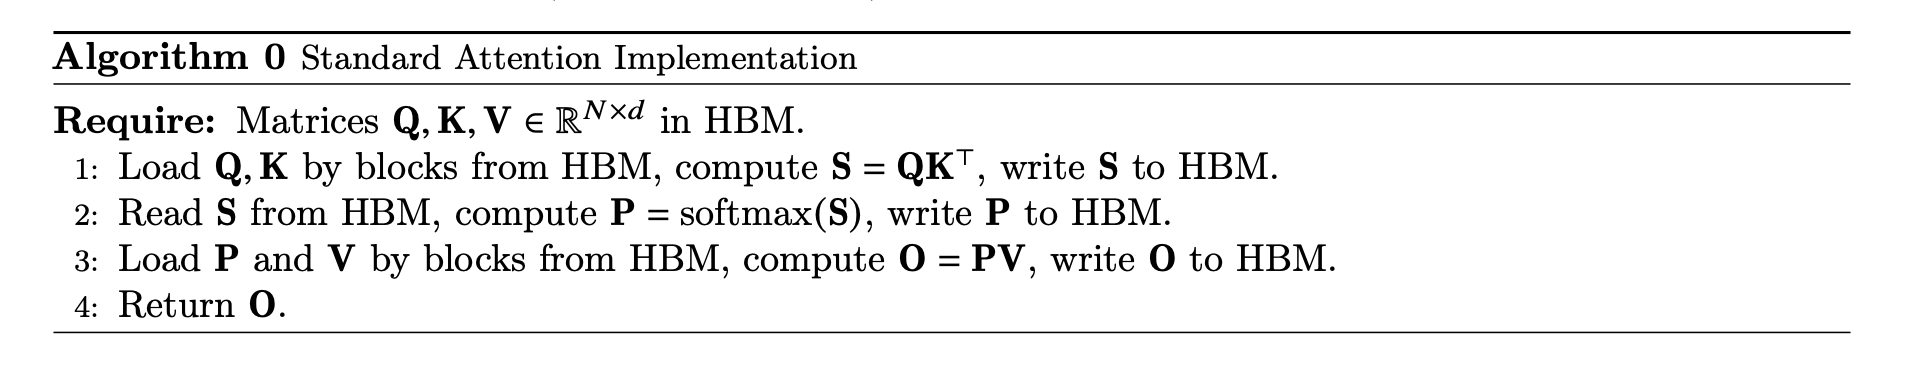
标准的 Attention 算法对于 (1) 需要从 HBM 读取 2 次,写入 1 次,对于 (2) 需要从 HBM 读取一次,写入一次,对于 (3) 需要从 HBM 读取 2 次写入一次。为了减少对于 HBM 的读写,FlashAttention 分块将数据送入 SRAM。但分块后需要计算 softmax,而 softmax 需要读取一行作为分母,因此难点主要在分块算 softmax。
(5) (6) (7) (8)
随后描述了一种分块算法,例如对于一行进行切割
然后 FlashAttention 给出了如下算法: 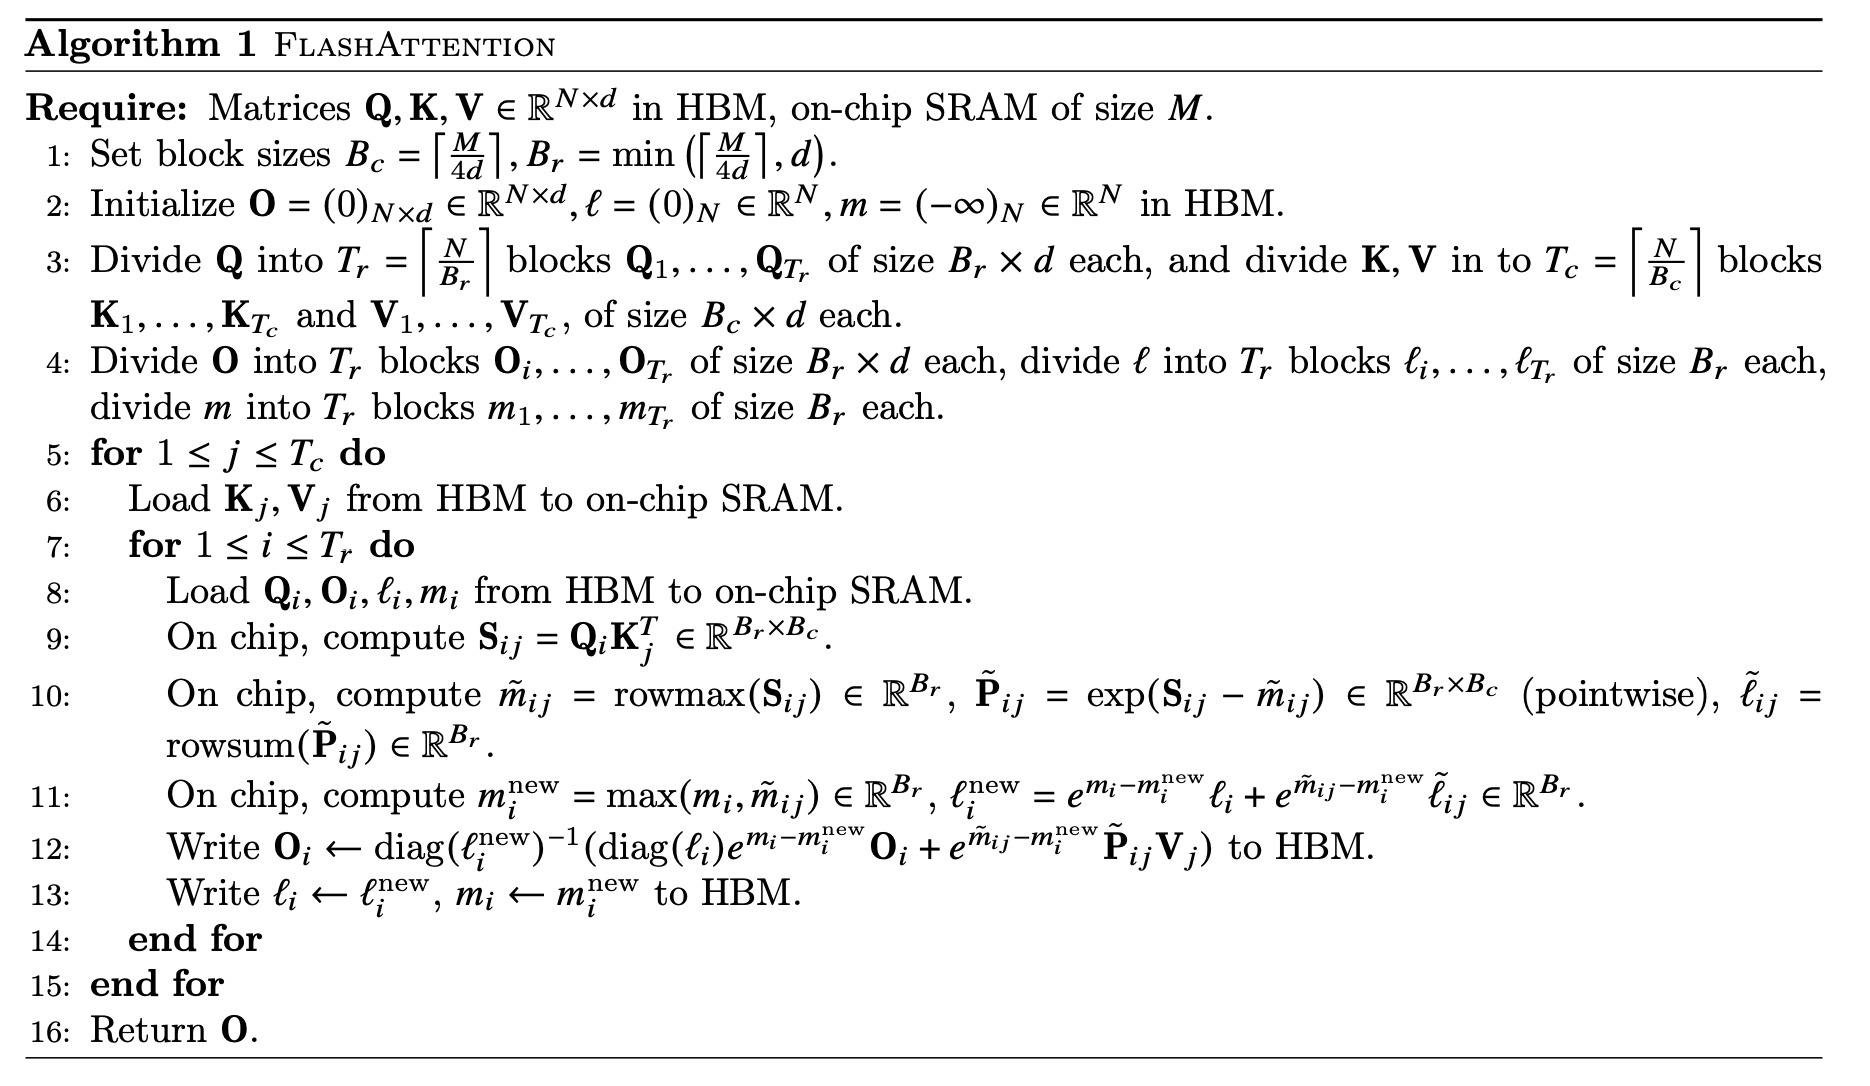
L1: 根据 SRAM 的大小选择合适的分块大小
和 。 L2:初始化一些变量
L3 & L4: 将矩阵
沿着行方向切分成 块,将向量 切成 块,将 沿着行方向切成 块。 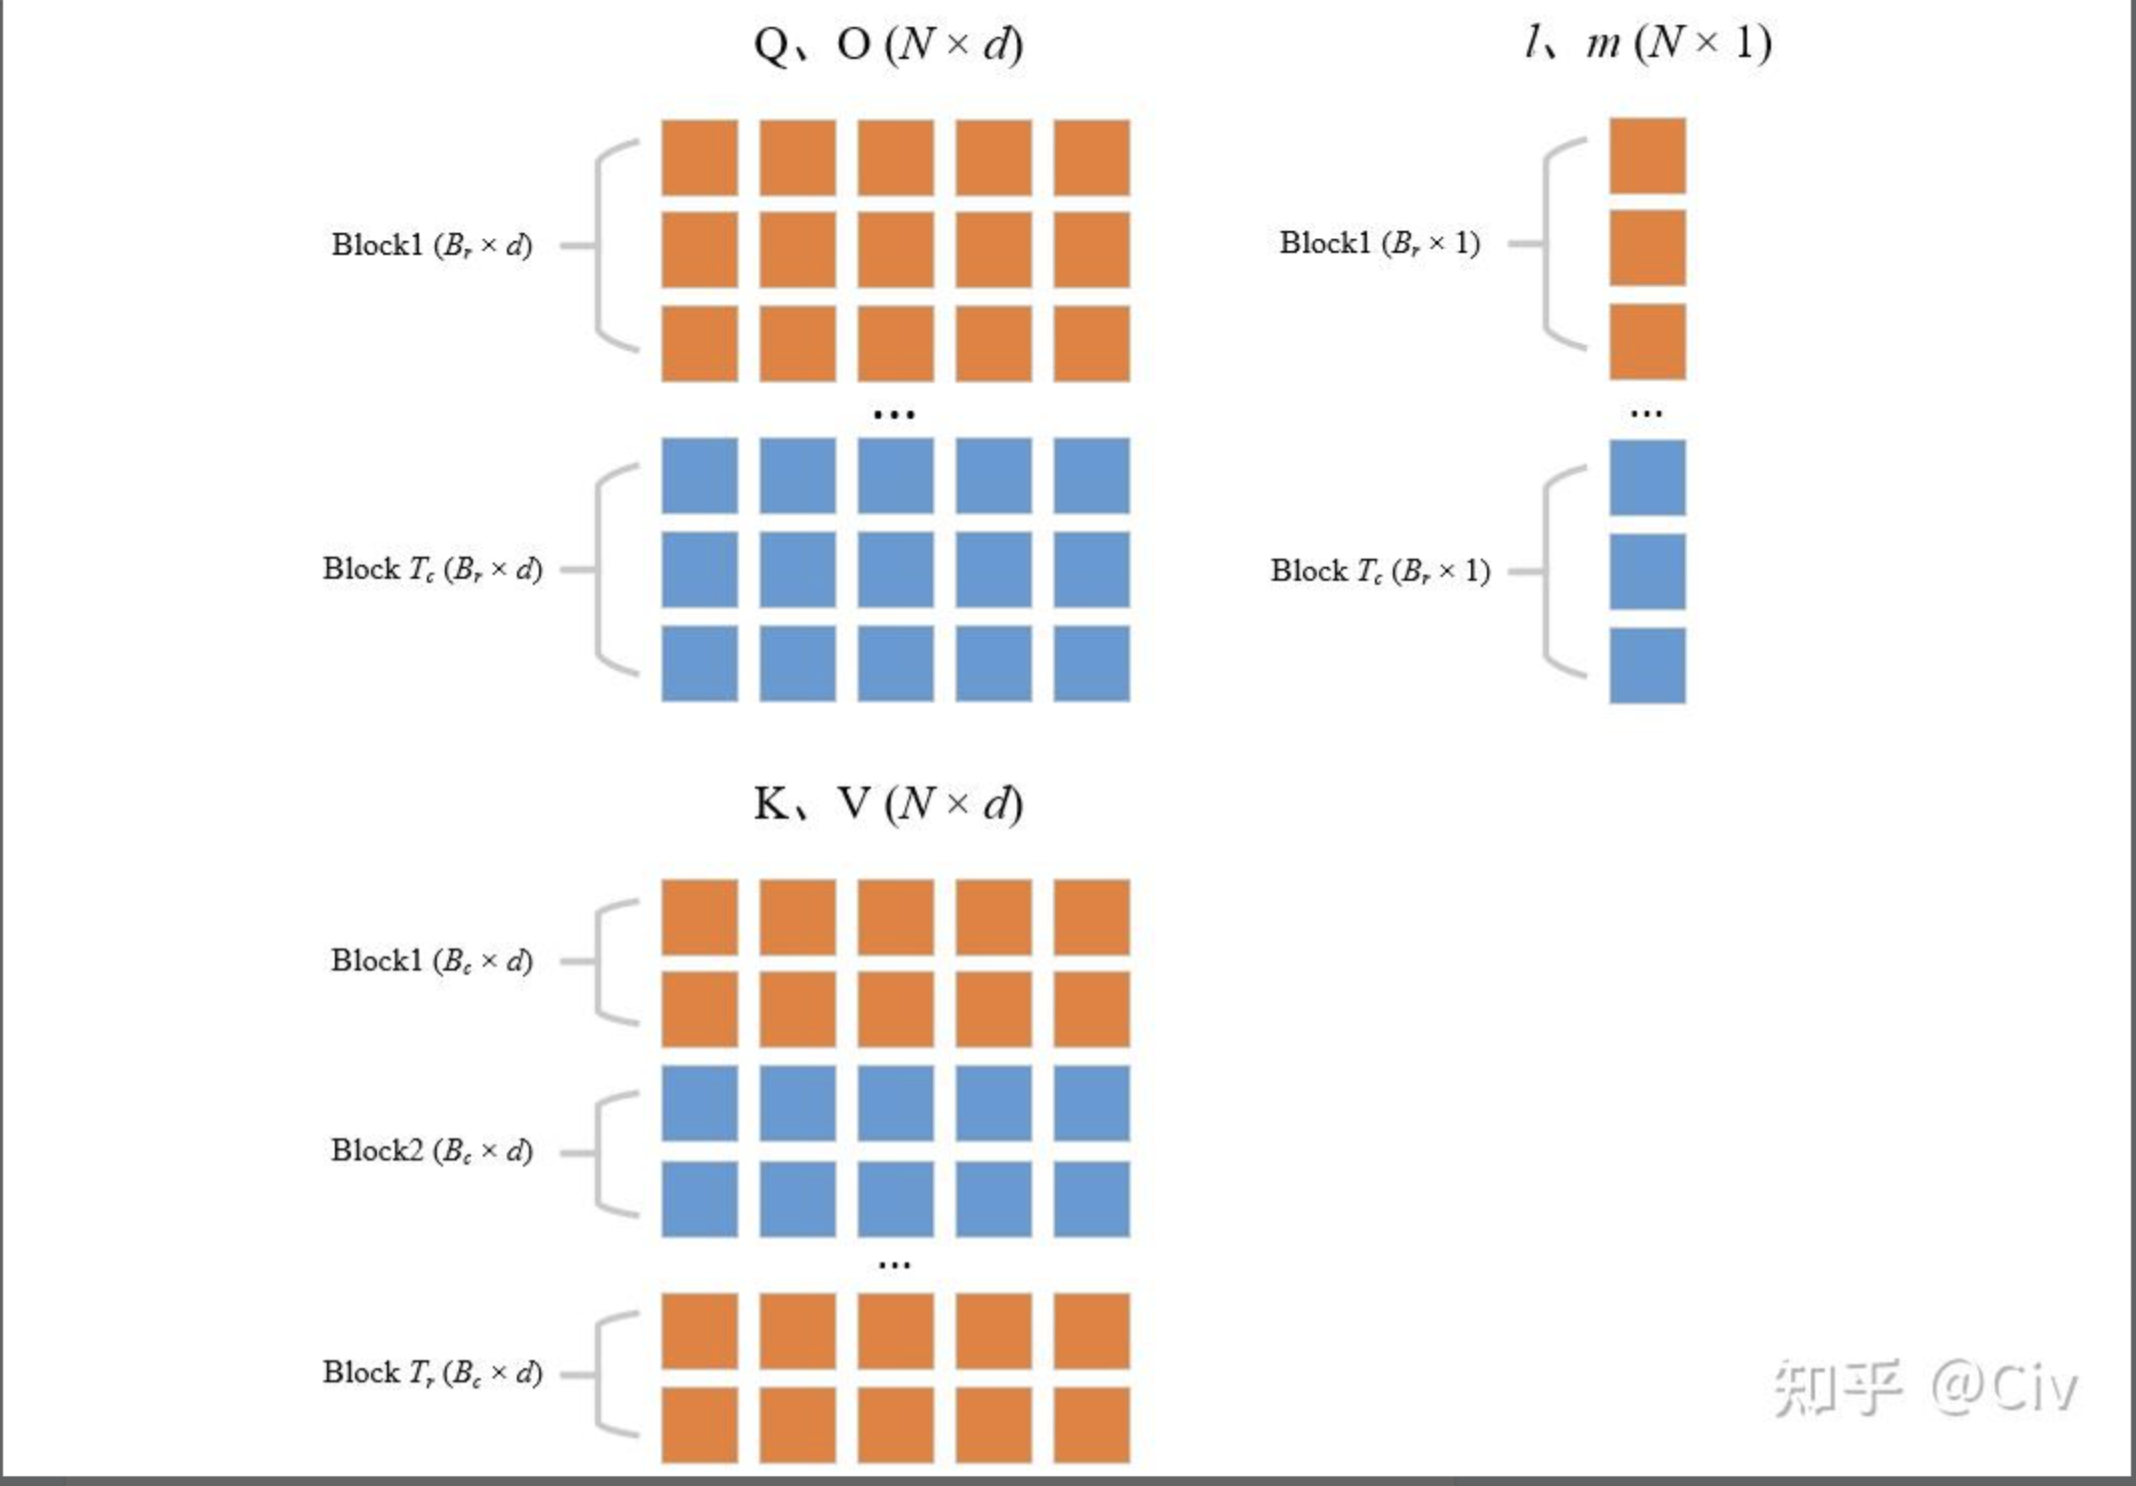
L5: 外循环遍历 K,V
L6: 将遍历的
从 HBM 读入 SRAM。 L7: 内循环遍历
L8: 内循环变量读入 SRAM
L9: 使用当前遍历的
,计算分块的 Attention Score = 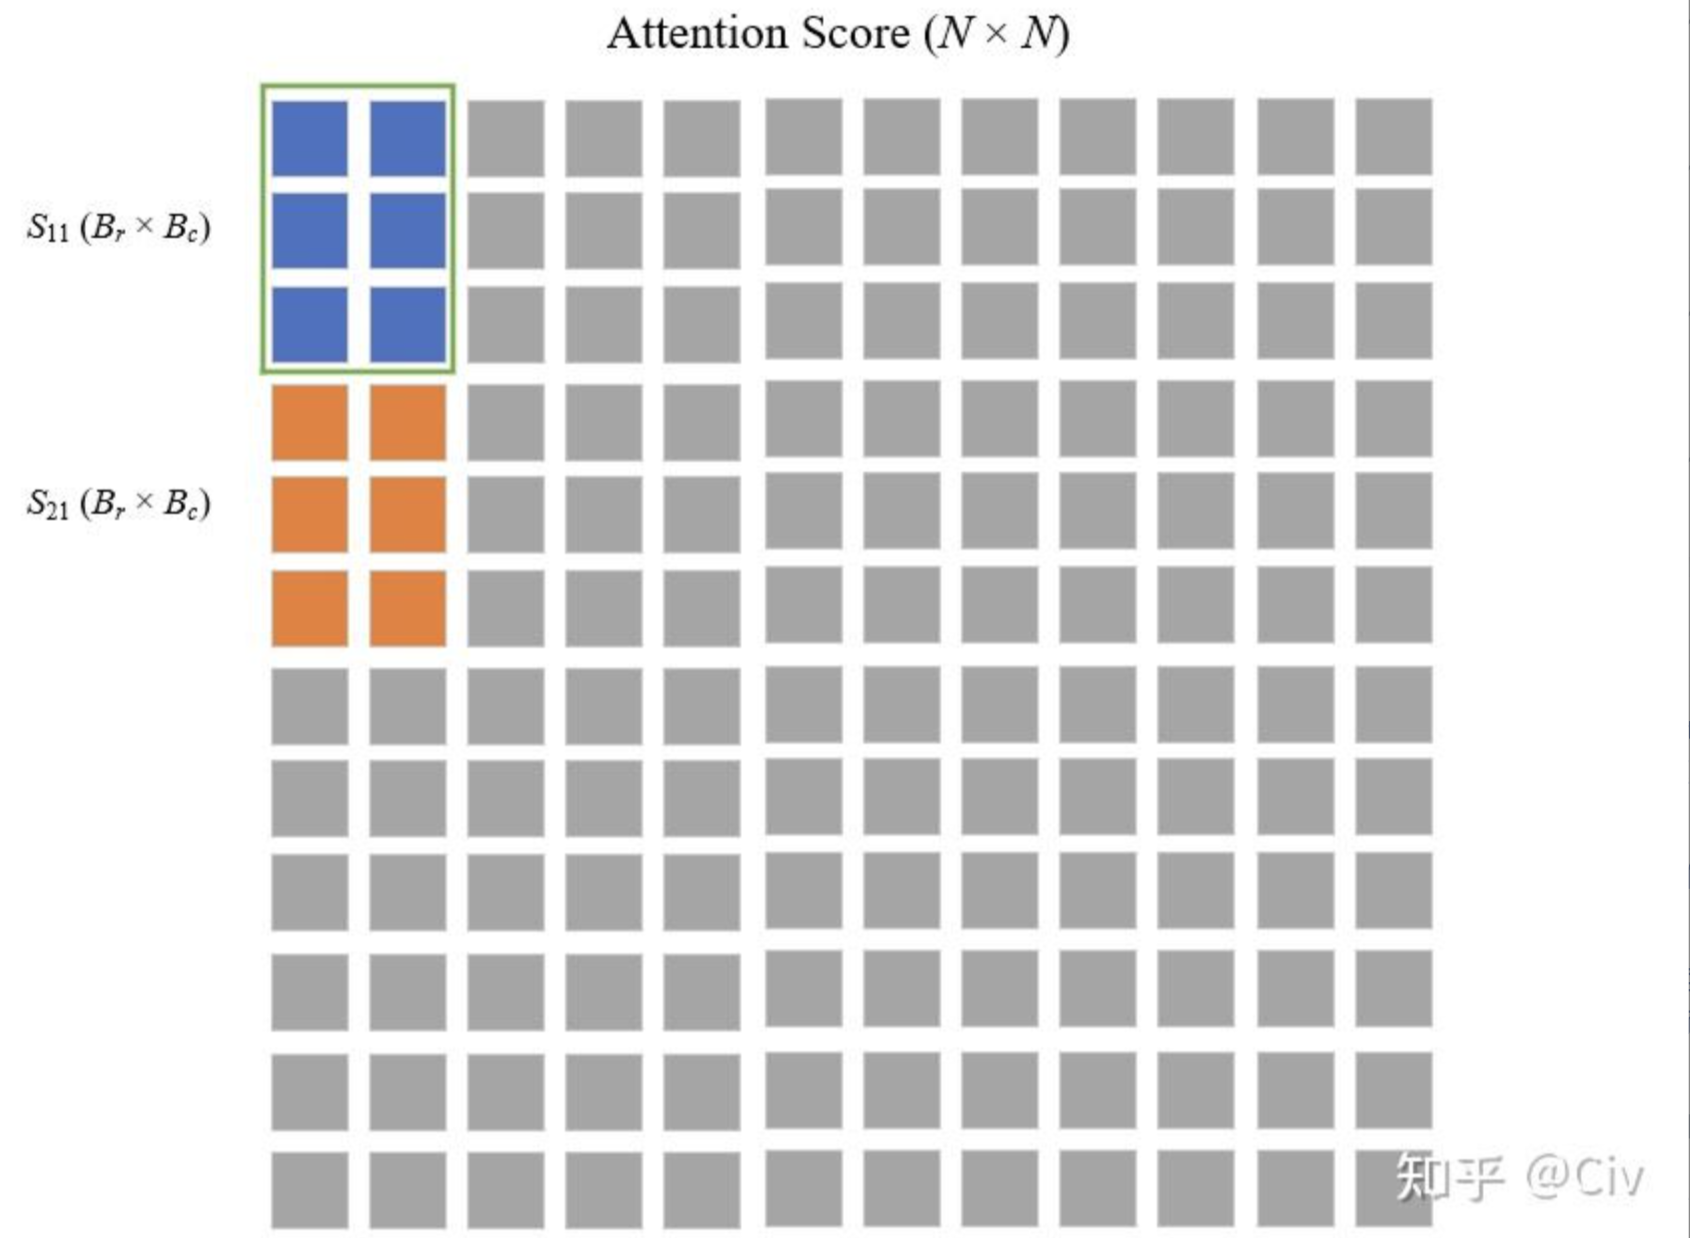
L10:对于分块的 Attention Score,计算每一行的最大值,指数项,求和项
L11: 更新