Kimi Linear:状态更新与混合注意力
来源:个人文章全文归档。
问题是线性状态的记忆容量与表达能力;设计同时包含 KDA 的状态更新和 KDA/全注意力混合层,不能只记住“把矩阵乘法交换顺序”。
整理与复习
- KDA 与全局注意力层的架构比例为 3:1,见论文的 KDA 与 architecture 部分。
- 旧笔记把 softmax 权重近似写为未归一化的指数核:归一化分母不能省略,有限维特征映射也不自动等价于精确 softmax。下方作为历史表述保留。
- 原文混用了“DeltaNet”和“Gated DeltaNet”;全局遗忘门应结合论文具体递推定义区分。
原笔记相关章节
Linear Attention(线性注意力)1
Kimi Linear Attention
Kimi Linear Attention 是月之暗面今年推出的一个线性注意力算法,目标在于在长序列的场景下,同时实现全注意力级别的效果和线性注意力的效率。Kimi Linear 通过 Kimi Delta Attention(KDA)—— 一种优化的线性注意力机制,解决传统线性注意力“表达能力弱,长序列干扰”的问题。
之前的线性注意力的问题在于为了实现线性复杂度,牺牲了注意力的全局关联性,同时用累计状态存储 KV Cache,会使得就信息不断干扰新信息,导致长序列任务准确率下降。
同时采取混合注意力的方法,经常在受限的规模或者在复杂的 benchmark 的情况下难以部署,因此 Kimi Linear Attention 希望提出既保留线性注意力的效率,又能达到全注意力的效果,同时还可以进行工业部署。
线性注意力原理
线性注意力的主要观点是,由于计算
我们可以把注意力权重的 softmax 看作一种核函数(衡量 qi 和 kj 的相似度):
这里的
其中
因此,交换矩阵乘法顺序,可得:
线性注意力还有一个更直观的视角,就是用全局状态替代注意力矩阵,我们可以把
Kimi Delta Attention
KDA 的本质是给线性注意力的**「状态累加」加「智能调控」**,解决早期线性注意力「表达弱、长序列干扰」的痛点。
在上一节中提到全局累计状态
而 DeltaNet 使用梯度下降更新修正
Kimi-Linear Overview
Kimi-Linear 通过 KDA 线性注意力 + 全注意力的混合架构,同时搭配 NoPE 编码,MoE 通道混合等关键组件,实现效果与效率的最优平衡。
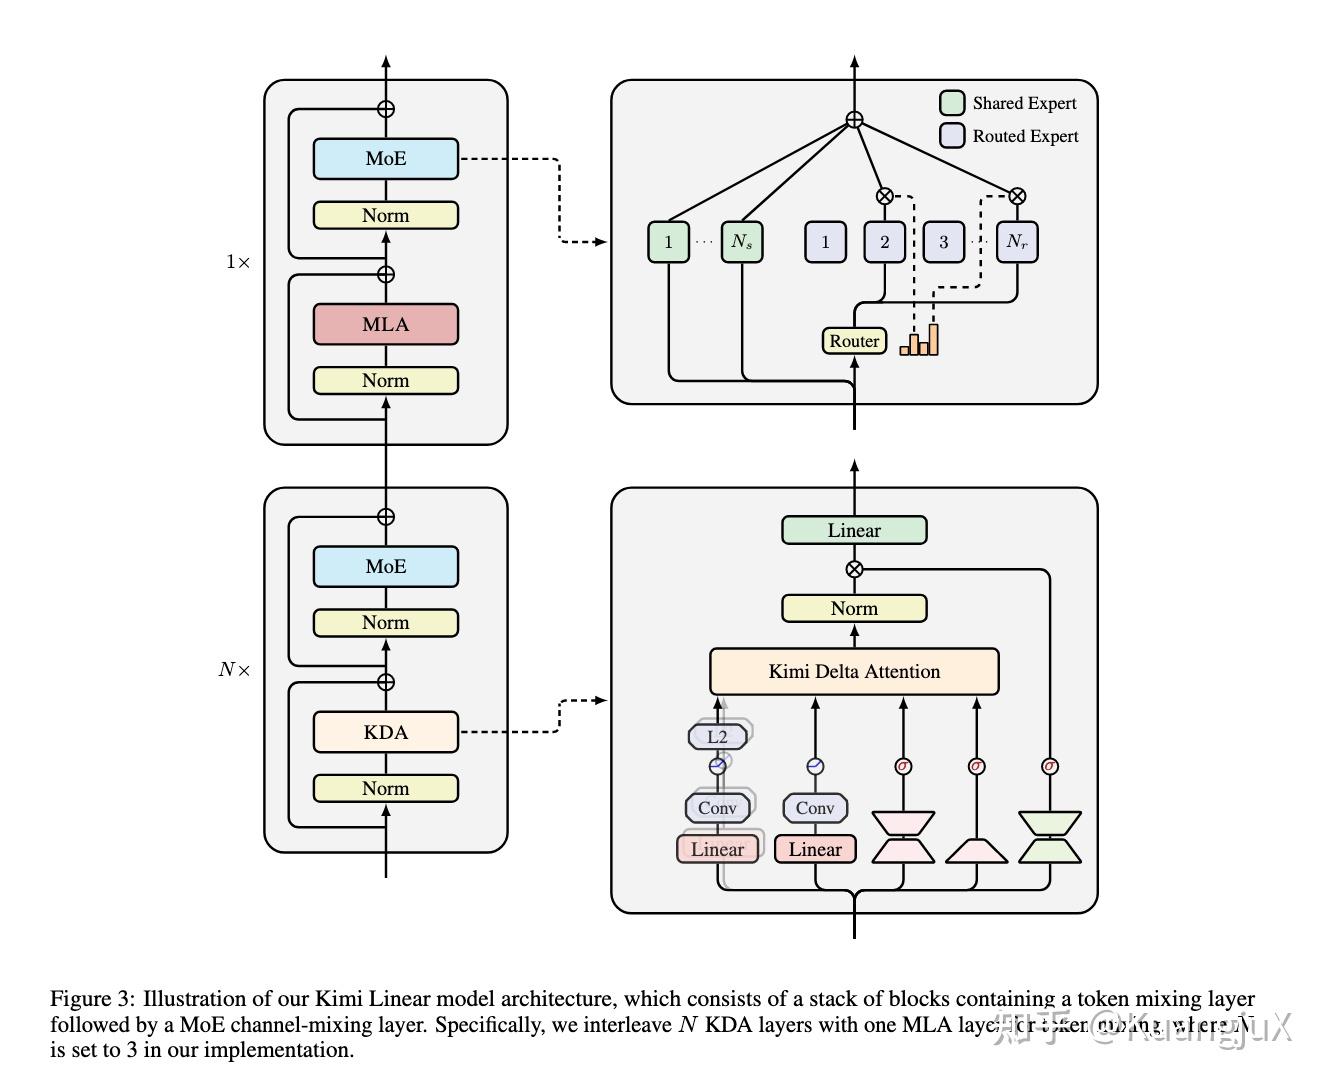
Kimi Linear 架构
Kimi Linear 通过 3:1 的 KDA:全注意力层的机构混合,KDA 负责长序列的流式处理,控制计算内存成本;全注意力层负责全局信息的跨位置流动,避免线性注意力的信息孤岛,提升复杂推理能力。
推荐一些线性注意力相关的文章:
苏神对线性注意力的介绍《线性注意力简史:从模仿、创新到反哺》:
大佬对线性注意力的图解:
作者本人对 Kimi Linear 的介绍: