Attention is all you need:历史笔记
易错概念
按原论文 §3.2,批量计算中的 Q、K、V、O 是矩阵或张量,单个位置的 query/key/value 才是向量;§3.2.3 的三种用法是 encoder self-attention、decoder masked self-attention、encoder–decoder attention。原笔记“比其他模型都要快”缺少评测范围,不能作为任意模型与任务上的结论。见论文原文。
相关基础笔记:Transformer。
历史阅读笔记
Abstract
序列转录依赖于循环包含 encoder 和 decoder,提出了一个简单的模型 Transformer,仅仅依赖于 attention,没有使用循环和卷积。
Introduction
主流模型 RNN 是一个时序模型,
Background
提出 MultiHead Attention 代替卷积神经网络的多通道。
Model Architecture
大部分 neural sequence transduction 模型有 encoder-decoder 架构。encoder 原始输入 -> 长度为 n 的机器学习向量,decoder: 编码器输出/解码器输出 -> 长度为 m 序列,是一个自回归的架构。 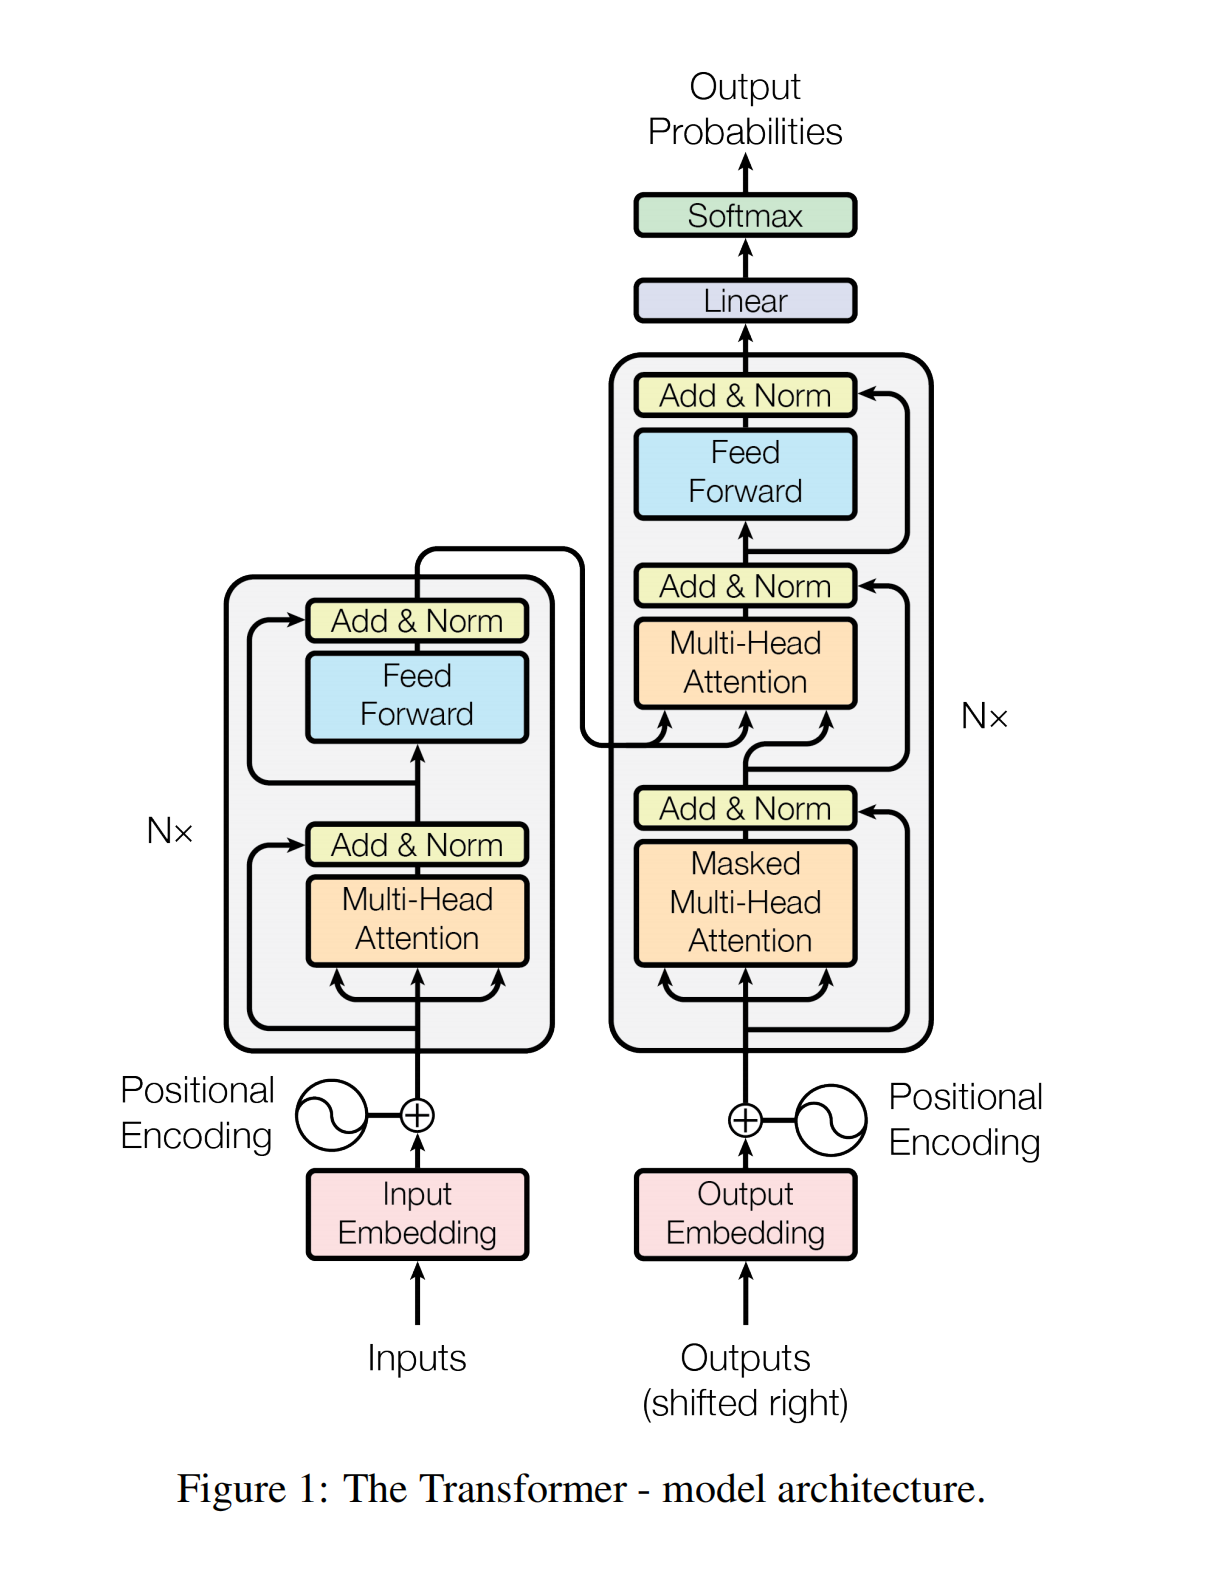
- Encoder(AI 中文转述,原论文 §3.1):原始配置堆叠 6 层,每层先做多头自注意力,再做逐位置的前馈网络。各子层使用残差连接,并在相加后做 LayerNorm;统一的表示宽度为 512。
- Decoder(AI 中文转述,原论文 §3.1):同样堆叠 6 层,在自注意力与前馈网络之外加入面向 encoder 输出的 attention。自注意力使用因果掩码,配合右移的目标输入,预测只能使用已知的历史位置。
原英文摘录仍可在 Issue #32 查看。
Attention
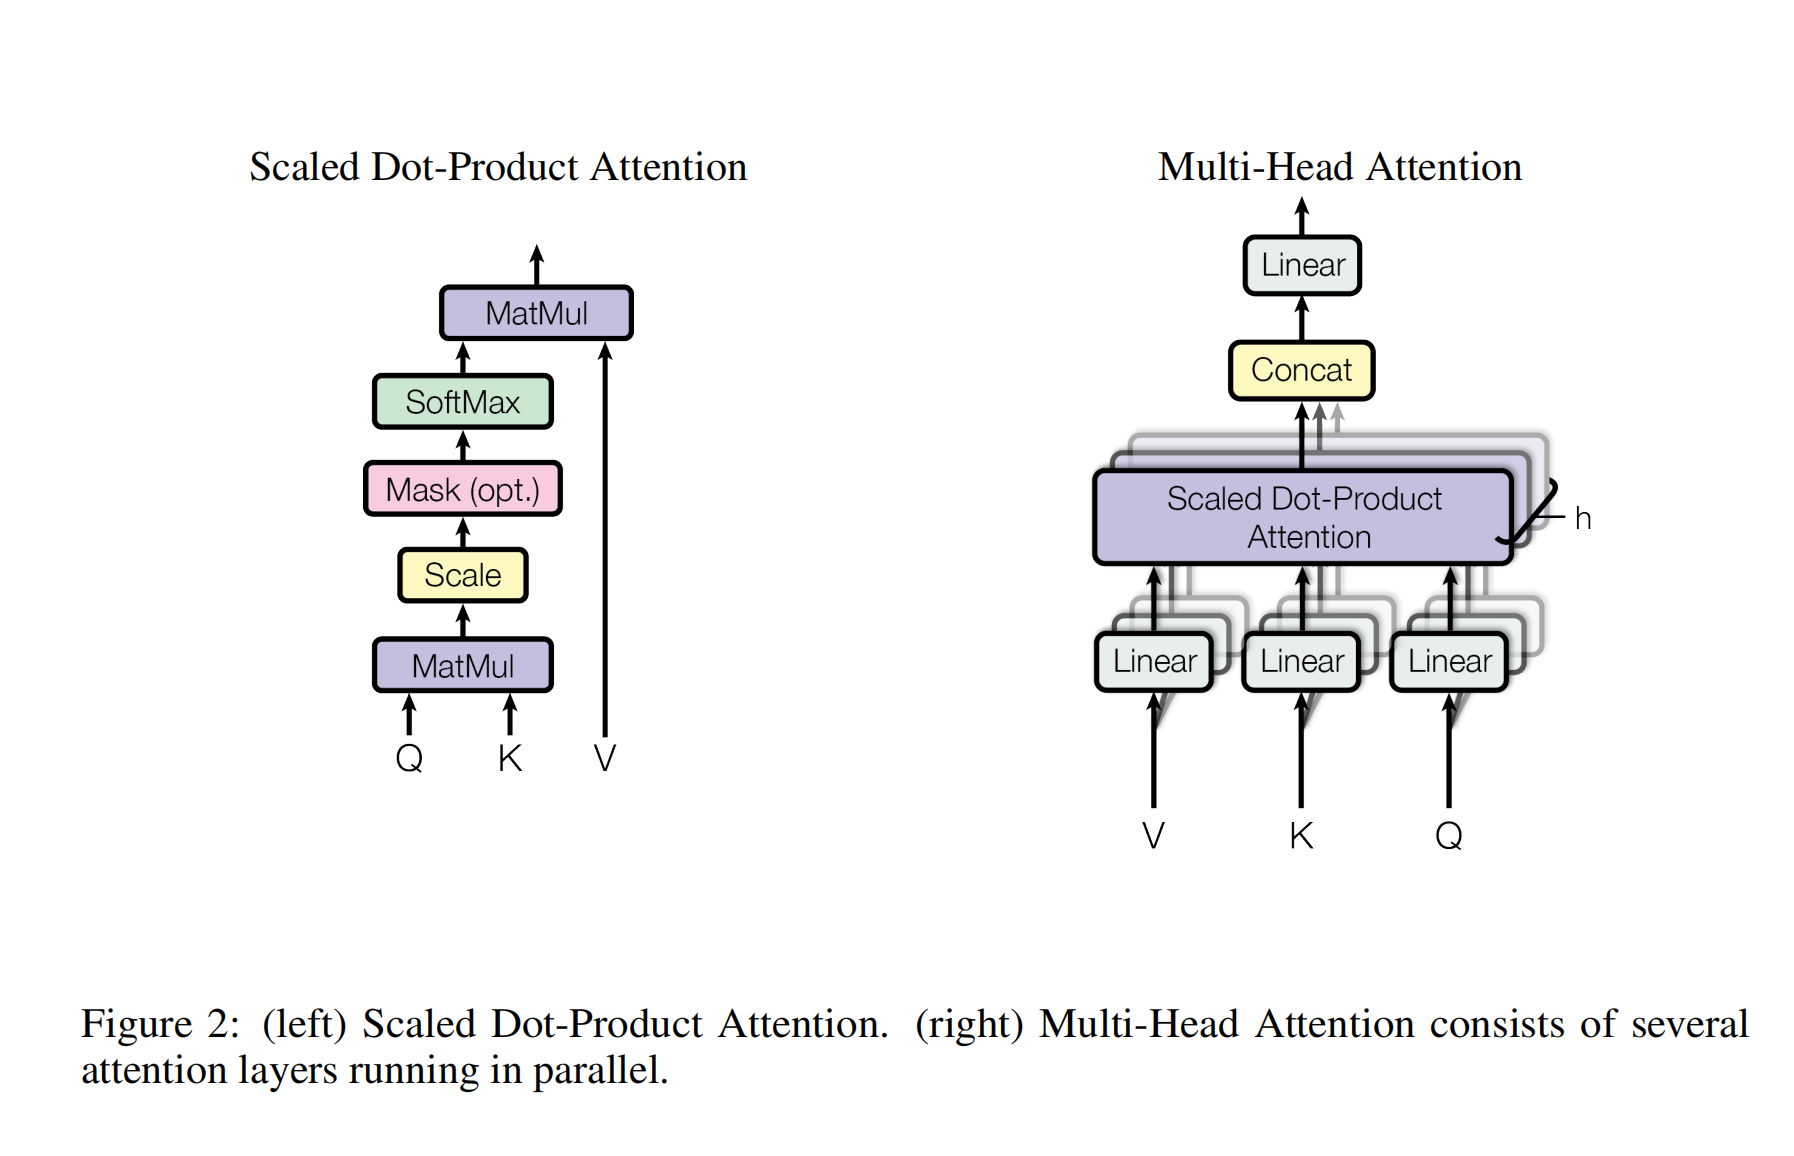
Attention 函数输入 query, key, value pairs 输出一个向量 outputs,其中 Q, K, V, O 都是向量,Transformer 使用了 Scaled Dot-Product Attention:
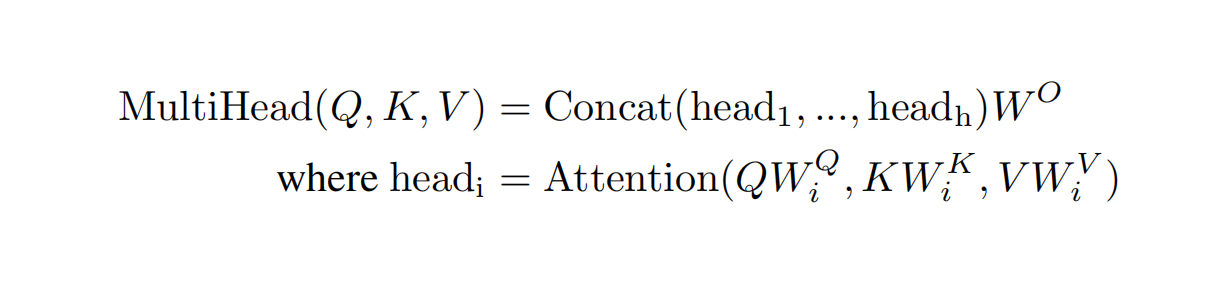
Multi-Head Attention
Applications of Attention
Transformer 有三个 Attention。
Positional Encoding
语义会发生变化,因此需要加入时序信息,在输入中加入时序信息。
Conclusion
仅仅使用 self-attention 的模型 Transformer 比其他模型都要快。