DeepSeek-V3.2-Exp: Boosting Long-Context Efficiency with DeepSeek Sparse Attention
主要来源:DeepSeek-V3.2,第 2.1 节与附录 A
MLA 来源:DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model
Kernel 实现:DSA Sparse Attention:Kernel 实现与公开性能
Background
设序列长度为
DSA 的目标是让昂贵的 MLA 主注意力只读取固定数量
为此,它额外运行一个计算更便宜的 Indexer。Indexer 本身仍然要给 token pairs 打分,因此仍含
Notation
| 符号 | 含义 |
|---|---|
| 位置 | |
| Lightning Indexer 的 query/scorer head 数 | |
| 每个 Indexer head 的维度 | |
| query token | |
| 第 | |
| 历史 token | |
| Indexer 对 token pair | |
| query | |
| MLA 将 token | |
| decoupled RoPE 的共享 key 部分 | |
| 主注意力第 | |
| 在 | |
| 注意力层最终输出 |
DSA Design
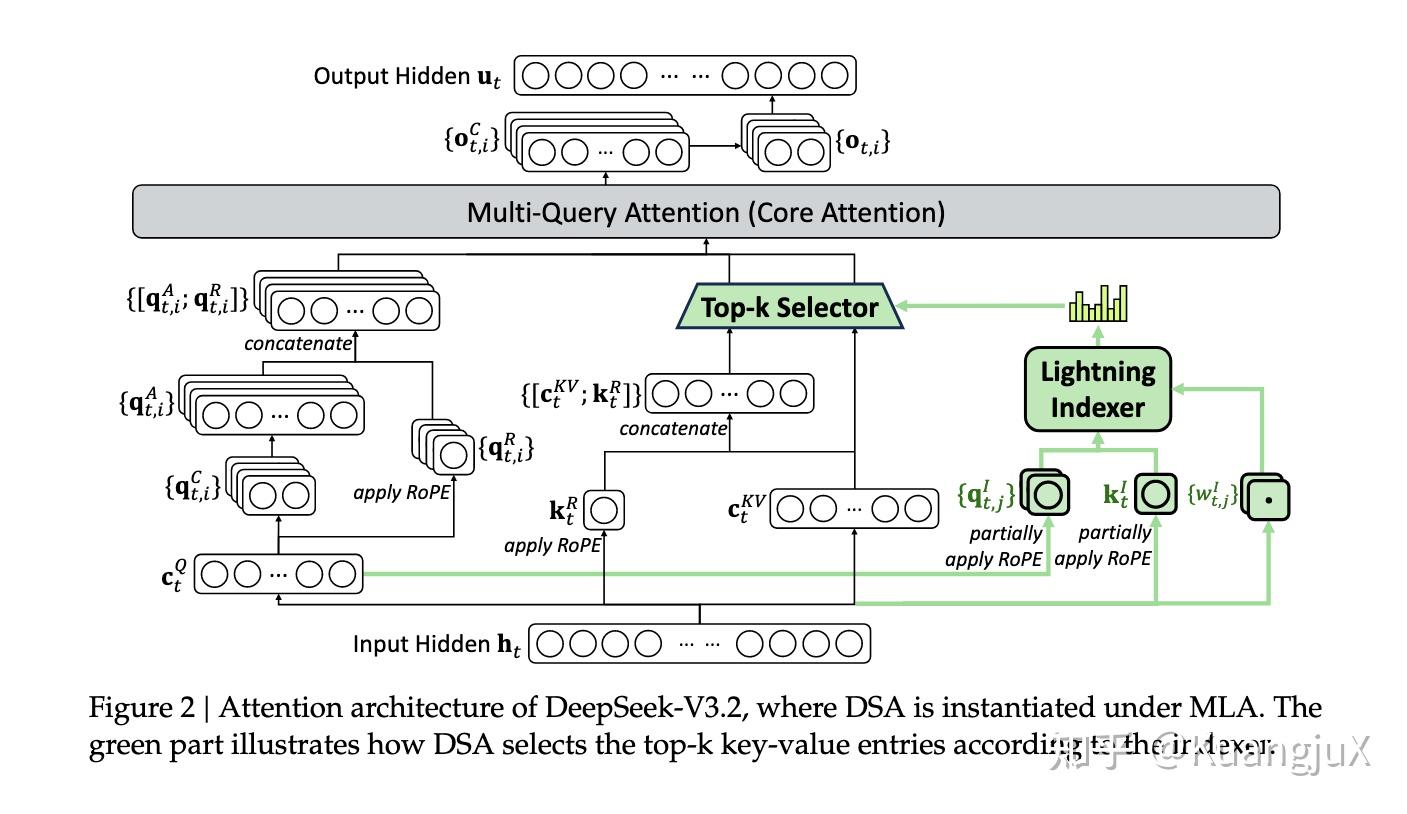
DSA 架构图,引用自 2025 年度 LLM 研究总结。主注意力只读入选位置,不代表从 KV cache 永久删除其他位置;后续 query 仍可能选中它们。
正在渲染流程图…
选择阶段只交出地址,主分支仍需在这些地址上计算每个 head 的注意力。这一分工让主分支节省计算,也引入了索引扫描和离散 gather 的成本。DeepSeek-V3.2 §2.1。
Lightning Indexer
对 query token
对每个历史 token
可以把
论文公式 (1):
逐步理解:
- 每个 Indexer head 计算一个 dot product;
- ReLU 将负相关项截为 0,论文选择它主要是出于吞吐考虑;
- 用 query-dependent
加权; - 对
个 scorer heads 求和,得到一个标量 。
因此,虽然 Lightning Indexer 内部是 multi-head,最终却不是每个 head 一份 Top-k,而是每个 query token 只有一张 token 排名表。
因果 attention 只允许
Top-k 只需要比较 index scores,不需要先对整条序列做 softmax。它的输出是整数 token indices,因此对普通反向传播不可微。
论文把被选中的主分支数据写作:
这里的
选择单位是 token 位置,读取的是该位置的压缩表示。
MLA Representation
MLA 不直接为每个 token 缓存所有 heads 的普通 K/V,而是先下投影:
第
如果真的先执行这两次上投影,再运行普通 multi-head attention,就是 MLA 的 MHA-mode 表达。
为了让低秩压缩与 RoPE 兼容,MLA 将位置相关部分分离出来。可以把每个 token 的逻辑 KV entry 理解为:
:共享的压缩 content KV; :应用 RoPE 后的位置 key 部分,也在 heads 间共享。
DSA 选中 token
MLA MQA-mode
选中 token 后,如果先展开所有 heads 的 K/V,就会重新引入大张量的读取与存储。MLA 的 MQA-mode 利用线性代数把上投影吸收到 Query 和输出两侧,让多个 heads 直接读取同一 latent entry;这是稀疏 gather 能够摊销的前提之一。DeepSeek-V3.2 §2.1、Figure 2。
普通 content score 为:
利用结合律:
定义 absorbed query:
于是无需显式构造
对选中位置
然后只在 selected support 上归一化:
这里才是主模型真正使用的 attention score / probability。它与 Indexer score
如果显式恢复每个 head 的 Value,输出是:
因为
先在 latent 空间聚合:
再把
代码中常见的 uo_proj 对应的就是这类融合输出映射。
uo_proj 的输入是加权 latent output,不是 Indexer score 或 attention logit。
vanilla MQA 让所有 Query heads 直接共用一组普通 K/V。MLA MQA-mode 共享的是 latent memory
- 不同的
; - 不同的
; - 不同的 softmax 分布
; - 不同的
输出映射。
所以“所有 heads 共享 latent entry”不意味着所有 heads 的注意力行为相同。
Indexer 分数决定位置;主 attention logits 决定这些位置上的概率;概率加权 latent KV 后才得到 uo_proj 的输入。下面用一次前向连接这三类数据。
def dsa_forward(h_t, t, index_cache, mla_cache, k=2048):
    # Lightning Indexer
    q_idx, w_idx = index_query_proj(h_t)          # [H_I, d_I], [H_I]
    k_idx = index_cache.visible_keys(t)           # [t, d_I]

    pair_scores = relu(q_idx @ k_idx.T)           # [H_I, t]
    index_scores = (w_idx[:, None] * pair_scores).sum(dim=0)
    selected = causal_topk(index_scores, k)        # integer token positions

    # Gather MLA latent entries selected by DSA
    c_kv, k_rope = mla_cache.gather(selected)

    # Exact main attention, one distribution per MLA Query head
    q_absorbed, q_rope = mla_query_proj(h_t)
    logits = (q_absorbed @ c_kv.T + q_rope @ k_rope.T) * attn_scale
    probs = softmax(logits, dim=-1)

    # Aggregate in latent space, then recover final hidden output
    latent_outputs = probs @ c_kv
    u_t = uo_proj(latent_outputs)
return u_t这段伪代码只表达数据依赖;attn_scale 对应前述主分支缩放,省略投影内部细节和短前缀有效长度处理,不代表官方 kernel 的布局或融合边界。
Indexer Training
主前向依赖:
I_t,: → integer Top-k indices S_t → gather latent KV → main output → LM lossTop-k 输出离散整数下标。只要排名不变,小幅修改
DSA 将主 attention 信息跨所有 attention heads 聚合,再沿历史序列轴做 L1 normalization,得到一份共享教师分布:
之所以跨所有 heads 聚合,是因为 DSA 最终也只产生一份供所有 Query heads 共用的 Top-k token list。
Indexer 学习的目标是:
正在渲染流程图…
前向上两者互相依赖:Indexer 决定主模型看到哪些 token,主模型又给 Indexer 提供教师分布。反向上则刻意隔离:
| 损失 | 更新对象 | 为什么到不了另一侧 |
|---|---|---|
| LM loss | 主模型 | Top-k 不可微,无法到达 Indexer |
| Indexer KL | Lightning Indexer | Indexer 输入 detach;教师分布不参与反传 |
main_output, main_attention = dsa_or_dense_attention(...)
lm_loss = language_modeling_loss(main_output, labels)

teacher = aggregate_heads_and_normalize(main_attention).detach()
student = softmax(index_scores_on_current_support)
indexer_loss = kl_divergence(teacher, student)

# 梯度边界:
# lm_loss      -> main model only
# indexer_loss -> indexer only, because indexer input / teacher are detachedDense Warm-up
DeepSeek-V3.2 从已经扩展到 128K context 的 DeepSeek-V3.1-Terminus checkpoint 继续训练。新加入的 Lightning Indexer 还没有选择能力,因此先执行短暂 dense warm-up。
- 主分支继续运行 dense attention,不让随机 Indexer 控制路由;
- 冻结除 Lightning Indexer 之外的全部模型参数;
- 对第
个 query,将主注意力量跨所有 heads 求和; - 沿序列维做 L1 normalization,得到
。
论文公式 (3):
教师在前,Indexer 分布在后。直观上,主注意力认为重要但 Indexer 低估的 token 会受到更强惩罚。
| 项目 | 取值 |
|---|---|
| 学习率 | |
| 步数 | 1000 steps |
| 每步数据 | 16 sequences |
| 总 token 数 | 约 2.1B |
| 可训练参数 | 仅 Lightning Indexer |
| 主注意力 | Dense |
这个阶段的目标不是让主模型适应稀疏性,而是先让 Indexer 学会模仿一个稳定的 dense teacher。
Sparse Training
Warm-up 后正式启用 Top-2048 token selection,并让主模型适应稀疏 support。
对每个 query token:
主 MLA attention 只读取
论文公式 (4):
这里
主模型与 Indexer 沿前述两条梯度路径分别更新,但教师也缩到了已选集合。因此当前 KL 只能对齐集合内的分布,不能直接指出未被主分支读取的重要 token。这是由监督支撑集推得的限制;warm-up 提供初始选择能力,之后的质量仍需由稀疏训练和任务评估判断。
| 项目 | 取值 |
|---|---|
| 学习率 | |
| 稀疏预算 | 每个 query 选择 2048 个 KV tokens |
| 步数 | 15,000 steps |
| 每步数据 | 480 sequences |
| 总 token 数 | 943.7B |
| 主模型更新 | 仅 LM loss |
| Indexer 更新 | 仅 KL loss |
推理执行前述 forward,移除教师分布构造、KL 和 backward;主 attention 本身仍然存在。线上新增成本来自 Indexer 扫描、Top-k 和 gather,而非蒸馏损失。
Complexity
Indexer 仍对 token pairs 评分:
它能更快的关键不是复杂度阶数,而是:
较小; 较小; - 可以使用 FP8;
- 打分函数由 dot product、ReLU、标量加权和组成;
- 相比完整 MLA,不需要执行大规模 per-head softmax 与 Value aggregation。
DSA 的 2048 个位置可能高度离散,所选位置越分散,地址处理与 gather 越难摊薄。MLA 的紧凑 latent cache 和所有主 Query heads 共享一份选择,让一次取回的 entry 可供多个 heads 使用;跨 query 的复用则取决于选择重合和 kernel 调度,不能由 DSA 定义保证。
因此 MQA-mode 提供了有利的存储与复用条件,但实际收益仍需包含 Indexer、Top-k、gather 和主 attention 的完整测量。抽象的稀疏选择算法并不要求所有模型采用 MLA。