Skip to content

Kimi Linear: An Expressive, Efficient Attention Architecture ​

Kimi Linear 用 Kimi Delta Attention(KDA)维护固定大小的状态,并以 3:1 的比例混合 KDA 与全注意力层。核心取舍是:状态压缩减少长序列的存储与计算,但有限状态中的旧信息会相互干扰,需要控制记忆的保留和更新。论文 §2–4

KDA Design ​

对核形式的注意力,若相似度可写成 ϕ(q)Tϕ(k),可以先累计 key/value,再用 query 读取。采用列向量约定,因果形式为:

St=St−1+ϕ(kt)vtT,zt=zt−1+ϕ(kt),ot=StTϕ(qt)ztTϕ(qt).

分母非零时,该式保留了核权重的归一化。例如标量特征均为 1,两个 value 为 2、4,则 S2=6,z2=2,输出为 3;省去分母会得到 6。指数点积核与 softmax 权重也不能直接画等号:softmax 还包含逐行分母,有限维特征映射通常只近似指数核。

若特征宽度 d′ 和 value 宽度 dv 固定,状态大小为 d′×dv,长度为 n 的更新与读取约需 O(nd′dv) 运算。它避免保存逐 token KV,但所有历史信息挤入同一个状态;简单相加既不能主动遗忘旧关联,也不能修正已经写入的错误关联。

DeltaNet 将状态看作关联记忆:用重构损失 12∥STkt−vt∥2 的梯度更新,纠正当前 key 对应的 value。Gated DeltaNet 在此基础上加入标量遗忘门;KDA 改为按 key 特征维度控制的对角门。论文 §2.2、§3 式 (1)

St=(I−βtktktT)Diag(αt)St−1+βtktvtT,ot=StTqt.

这里 St∈Rdk×dv,αt 控制旧状态各行的保留程度,βt 控制修正强度。先令 S¯t=Diag(αt)St−1,更新便是 St=S¯t+βtkt(vt−S¯tTkt)T。门作用于旧状态;新写入项不受“只有未遗忘维度才能写入”的限制。KDA 的输出使用上述递推定义,也不直接沿用上文核注意力的归一化公式。

例如取 dk=2,dv=1,St−1=[2,4]T、αt=[0,1]T、kt=[1,0]T、vt=3、βt=1,先得到 S¯t=[0,4]T,再写入后得到 St=[3,4]T。第一维的旧内容虽已清除,新内容仍可写入;取 qt=[1,0]T 时输出 3。这是用于说明更新顺序的算例。

Hybrid Architecture ​

Kimi Linear 以三层 KDA 配一层全注意力,配合 MLA、NoPE 和 MoE 组件。KDA 承担大部分状态更新,全注意力层提供直接的跨位置交互;因此整个模型的缓存与复杂度不能只按 KDA 单层计算。论文 §4
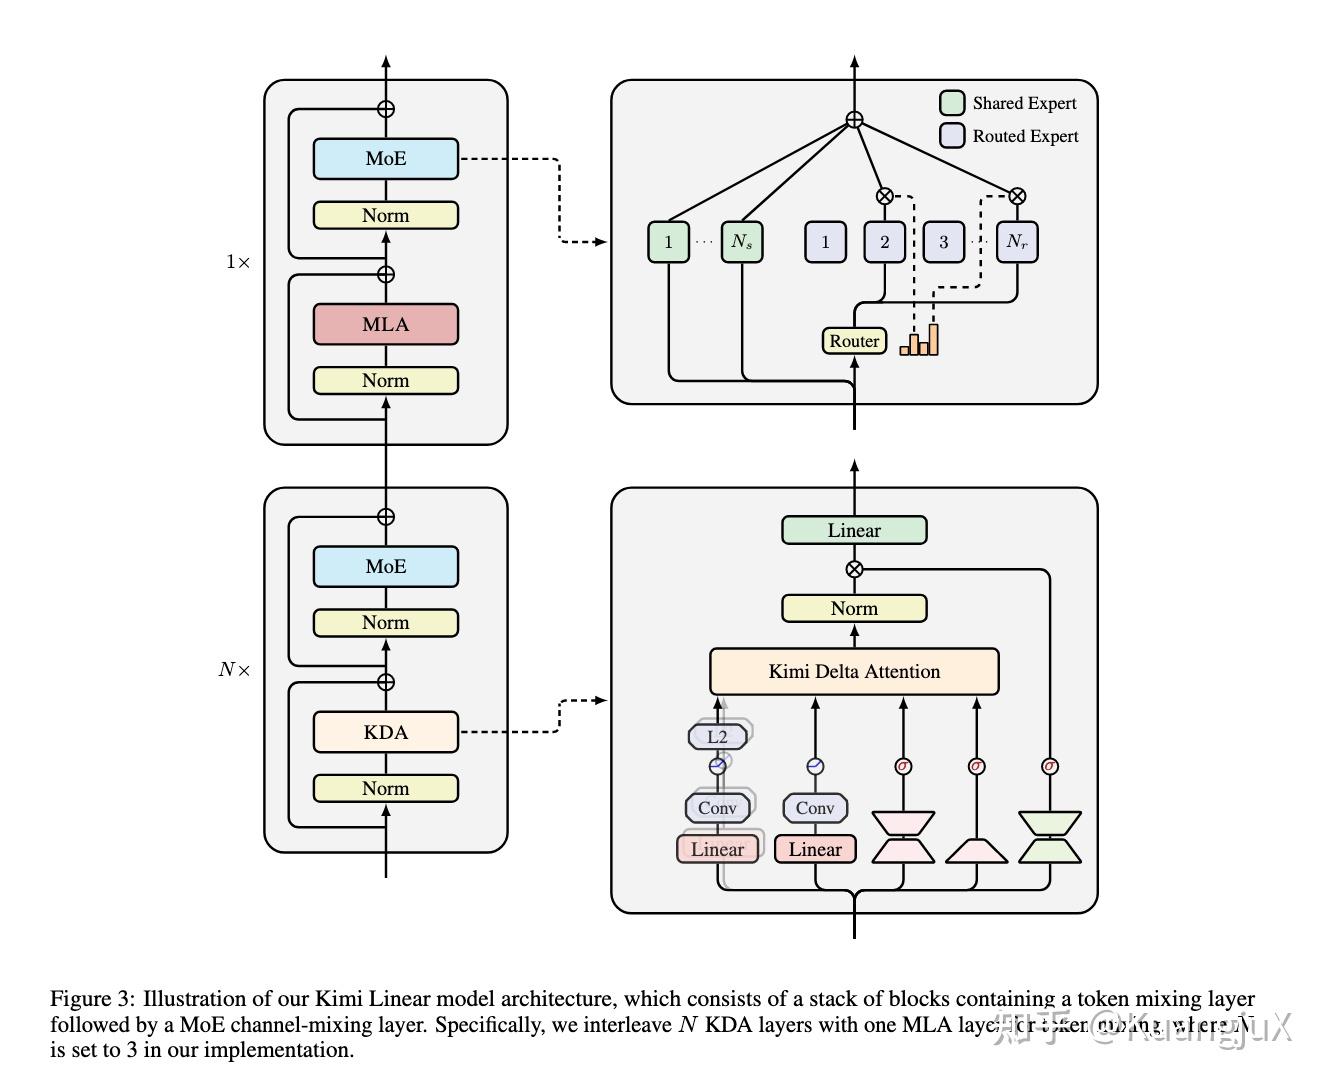
Kimi Linear 架构

架构图及原始讨论见 2025 年度 LLM 研究总结。混合比例与状态更新定义解释了设计选择,并不单独证明与全注意力在所有任务上等效。

记录原理、连接知识、积累实践。