The Tensor Algebra Compiler
稀疏张量计算的实现同时取决于代数表达式和存储格式:压缩存储通常不能高效随机访问,多个输入需要按坐标共同遍历;复合表达式若拆成多个库调用,还可能产生比输入、输出更大的中间张量。Kjolstad 等人在 OOPSLA 2017 提出的 taco(Tensor Algebra COmpiler),将张量索引表达式和格式描述编译为计算 kernel,以可组合的代码生成替代逐算子、逐格式手写实现。§1–2,pp. 1–4
Background
以张量乘向量(TTV)为例,
全部稠密时,三层循环遍历完整空间并用下标计算地址;
taco 用存储描述表示各层如何访问,用 iteration graph 表示循环的嵌套约束,再用 merge lattice 决定同一循环内多个输入怎样共同遍历。融合粒度仍由用户选择,编译器负责为给定表达式和格式生成实现。§2,p. 3;§6,p. 12
Tensor Storage
论文将张量表示为坐标树:每层对应一个维度,从根到叶的路径确定一个完整坐标,数值单独保存在 vals 数组中。格式由两部分组成:维度的存储顺序,以及每层使用 dense 还是 sparse。§3,pp. 4–6
- Dense 层保存维度大小,覆盖该维度的全部坐标,包括值为零的位置;已知父层位置后,可以通过乘加计算子层位置。
- Sparse 层使用
pos和idx:父层位置的子坐标位于 idx[pos[p]:pos[p+1]],段内坐标有序。遍历时先取得段边界,再顺序读取坐标;这里的存储位置与逻辑坐标不是同一个量。
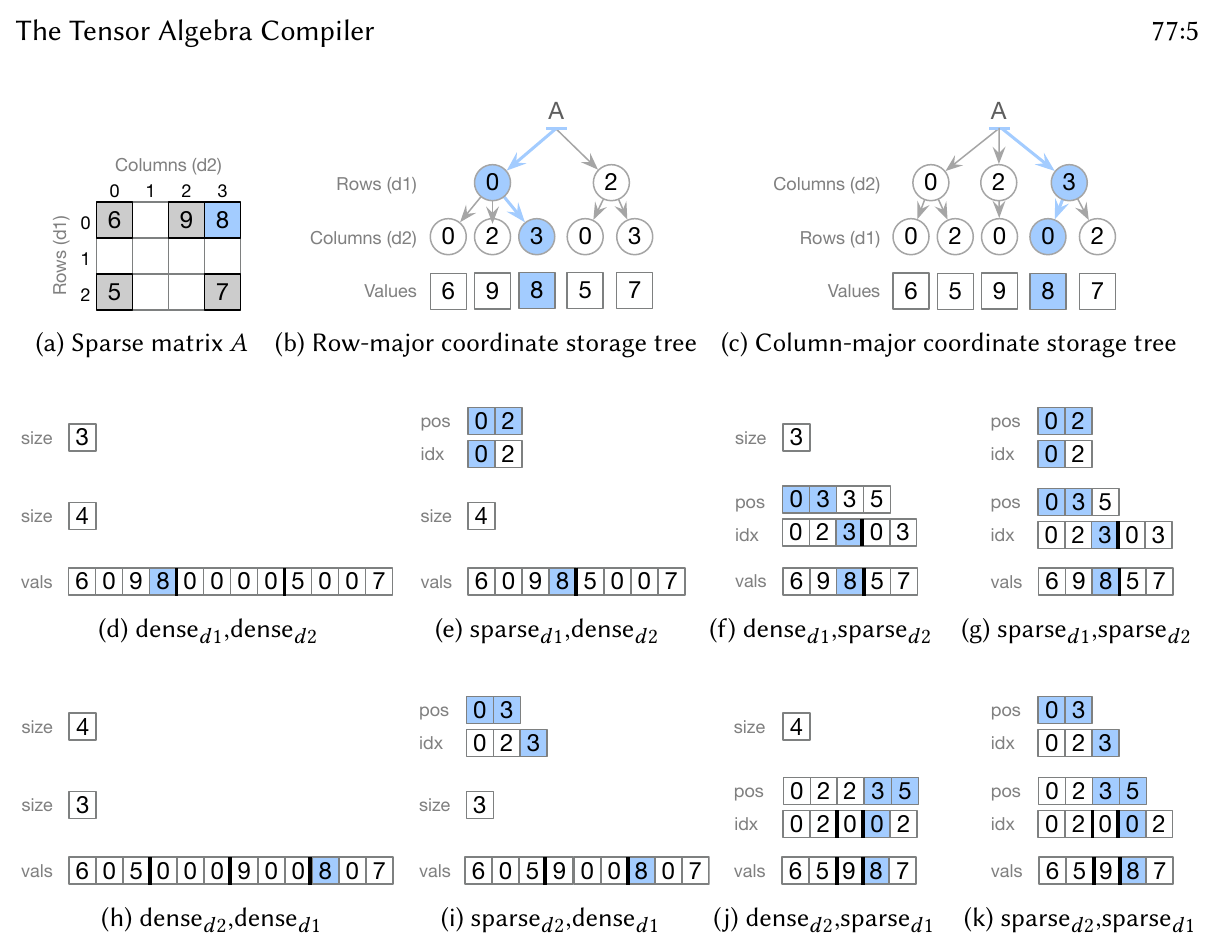
图 5(原论文 p. 5):同一矩阵可按行或按列组织坐标树,再分别选择各层的 dense/sparse 表示。原图来源
CSR 是“行在外、列在内”的 dense–sparse,CSC 交换两个维度的顺序;两层均 sparse 对应 DCSR/DCSC,高阶张量每层均 sparse 则对应 CSF。图 5(f) 的 CSR 中,pos=[0,3,3,5]:第 0 行的三个列坐标是 idx[0:3]=[0,2,3],第 1 行因相邻边界相同而为空。这样,循环生成只需组合每层的访问规则,而不必为每个完整格式另写一套逻辑。§3,pp. 5–6
Dense 层也能表示稀疏结构内部的小型稠密块。论文把 blocked SpMV 的矩阵表示为四阶张量,内部两个维度存储稠密块;这属于数据分块的表示能力,并不意味着已经支持通用的迭代空间 tiling。§3,p. 6;§10,p. 26
Iteration Graphs
Iteration graph 的节点是索引变量,每个张量访问形成一条按存储顺序排列的路径,输出张量也有对应路径。例如 CSR 的
对于
若格式约束冲突,例如 CSR 与 CSC 相加,路径可能形成环。迭代图能表示这种表达式,但本文的代码生成算法不能直接处理有环图;反向遍历压缩结构需要额外索引搜索,论文采用先转换格式来打破循环依赖的办法。因此,“支持张量索引表达式”不能理解为任意格式组合都可不经转换直接生成代码。§4,p. 8
Merge Lattices
同一个索引变量访问多个稀疏输入时,表达式决定哪些坐标需要参与计算:逐元素乘法对应交集,加法对应并集。归并格将这些关系进一步展开为输入耗尽前后的循环和每个循环内的计算分支,使编译器能为复合表达式生成有序归并代码。§5,pp. 8–11
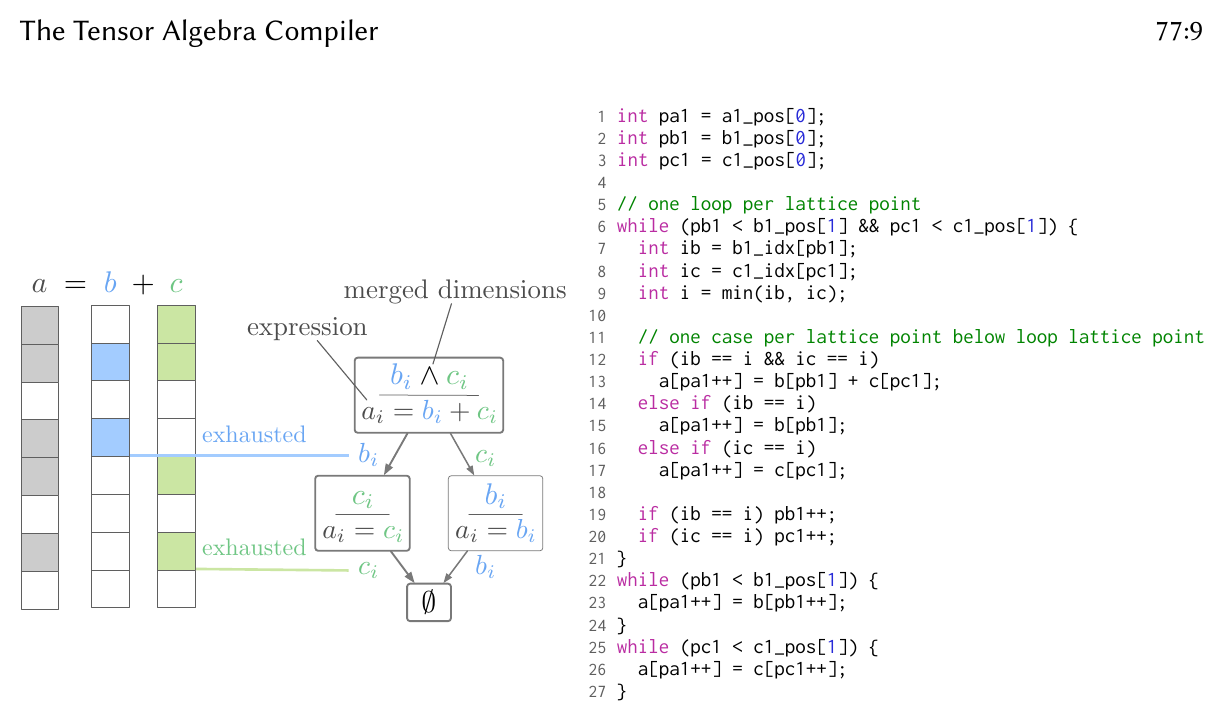
图 9(原论文 p. 9):
在两个向量都尚未耗尽时,循环取当前坐标的最小值:两者都有该坐标则计算
复合表达式也按相同规则构造。例如论文 Fig. 10(b) 的
先为
用集合记号解释这一机制(AI 解读),令
这里的“候选”描述结构上的参与关系,不保证结果值非零;例如同一坐标上的两项可能相消。图 9 的生成代码也直接存储加法结果,没有按结果是否为零做过滤。§5,Fig. 9
稠密输入允许简化归并:同一索引的多个稠密维度只需遍历其中一个;稠密维度覆盖完整坐标范围,耗尽后无需保留其他尾部循环;稠密与稀疏输入做乘法时,可以只遍历稀疏坐标,再随机读取稠密值。最后一项把 SpMV 等操作化为由稀疏输入驱动的计算。§5.2,p. 11
Code Generation and Fusion
代码生成沿迭代图的森林顺序递归。每个索引变量先构造归并格,生成对应循环与分支,再递归生成内层循环;同时根据存储描述计算位置,并插入数值计算与输出索引构造语句。对最内层的自由索引,编译器写出输出值;它以下的循环执行归约,它以上的循环可先计算已经具备输入的子表达式,以避免重复计算。§6.1–6.2,pp. 12–13,Fig. 11
稀疏输出还需要 assembly:向 idx 写入坐标,更新 pos 段边界,并在容量不足时扩容。父坐标下的输入即使各有非零项,内层交集也可能为空;因此构造上层索引时要确认内层确实产生了条目。Assembly 可以与 compute 融合,也可以分开;当重复计算只改变数值、稀疏结构保持不变时,已构造的输出结构可复用。§6、§6.3,pp. 12–14
融合还可以避免计算不会影响结果的中间值。SDDMM(sampled dense-dense matrix multiplication)为
其中
Evaluation
作者在 Intel Xeon E5-2695 v2(2.4 GHz)双路机器上测试,使用 GCC 5.4、MATLAB 2016b 和 128 GB 内存。输入来自 SuiteSparse、FROSTT 以及 Facebook wall-post 数据。默认报告单线程、冷缓存的平均执行时间;多线程结果使用 12 个线程,并通过 numactl 限制在一个 socket,因为当时的 taco 尚不支持 NUMA 感知代码生成。§8.1,pp. 16–17,Table 1
| 实验 | 作者报告的结果与比较范围 | 来源 |
|---|---|---|
| SpMV(稀疏矩阵乘向量) | 非分块矩阵上,taco 与 MKL、OSKI 等成熟实现的性能相近;有稠密块时,分块表示能改善性能,但串行 OSKI 在几乎所有所测案例中更快。taco 的块大小沿用了 OSKI 调优结果。 | §8.2,Figs. 14–15,pp. 17–18 |
| 复合线性代数 | 对 SDDMM、PLUS3、MATTRANSMUL、RESIDUAL 生成融合 kernel;SDDMM 减少无贡献的内积,后两项避免中间向量或额外拷贝。PLUS3 的时间包含输出索引 assembly;SDDMM、PLUS3 没有并行结果。 | §8.3,Fig. 16,pp. 18–20 |
| 高阶张量 | 在 Facebook、NELL-2、NELL-1 上测试 TTV、TTM(张量乘矩阵)、MTTKRP(matricized tensor times Khatri–Rao product)、加法和内积,taco 支持全部五项,快于 Tensor Toolbox 能完成的所测案例;后者在 NELL-1 的 TTM 上内存不足。MTTKRP 对 SPLATT 有胜有负,作者报告最差慢 1.53 倍。 | §8.4,Table 2,pp. 20–21 |
| 格式选择 | 对不同稀疏结构生成矩阵,比较格式的存储量和 SpMV 时间;不存在普遍最优格式,错误格式可能令两项成本增加多个数量级。 | §8.5,Fig. 18,pp. 22–23 |
Table 2 的三阶输入使用 CSF,输入矩阵和向量为稠密;MTTKRP 的并行行中,Tensor Toolbox 仍是串行实现,因此该行不能当作同线程数比较。SPLATT 在较大输入上通过提出重复乘法因子减少运算,论文当时的 taco 尚未做这项优化。§8.4,pp. 20–21
格式实验也解释了为什么“支持很多格式”具有实际意义。Row-slicing 与 column-slicing 矩阵具有相同密度,但行外层 sparse、列内层 dense 的格式适合前者,却可能为后者存储大量零;thermal 矩阵用该格式时也几乎存下整个矩阵,使 SpMV 从按非零项计算退化为二次工作量。格式选择必须考虑非零项的分布,而不只是整体比例。§8.5,pp. 22–23,Fig. 18
Scope and Limitations
本文解决的是给定表达式与格式后的代码生成。自动选择格式、决定表达式拆分或融合粒度、引入 workspace、迭代空间 tiling,以及 GPU/TPU 和分布式内存后端,均被列为未来工作。论文没有给出自动判断任意输入最优格式的方法,格式实验也不能视为已经实现自动调优。§10,pp. 25–26
2017 年实现的 OpenMP 并行生成只处理外层循环,并有三个限制:该循环必须是不需要归并的 for 循环;自由索引不能位于归约索引之下,以避免尚未处理同步的 scatter;输出的全部维度必须是 dense。这些限制与前述有环迭代图的限制共同界定了本文代码生成和并行实验的适用范围。§6.4,p. 14