FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
- 论文:原文
原笔记参考:知乎文章。
Background
Self-Attention 的计算过程是: 三个矩阵
(1) (2) (3)
Self-Attention 中(1) 和 (3) 的计算最密集,(1) 和 (3) 中的矩阵乘法复杂度为
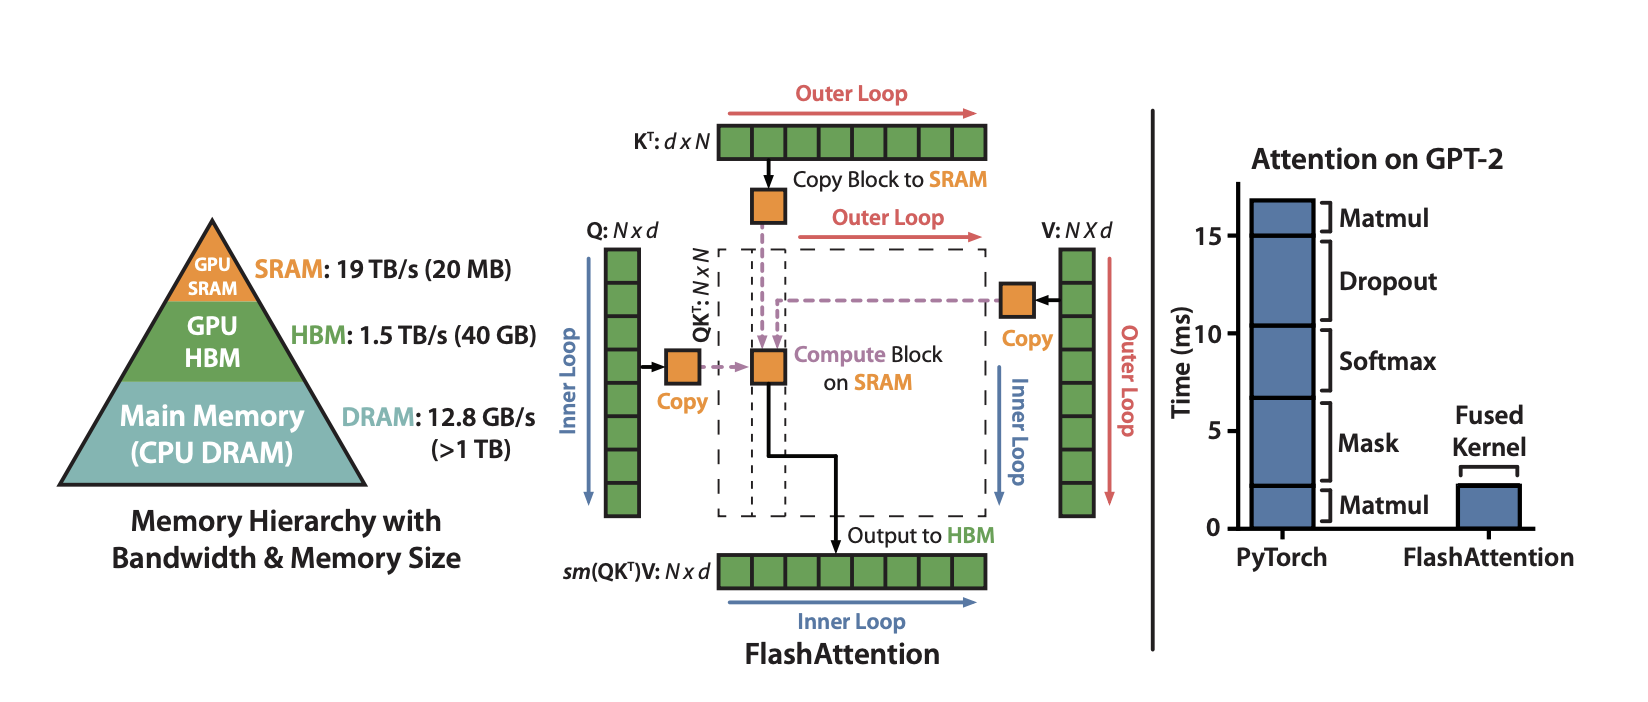
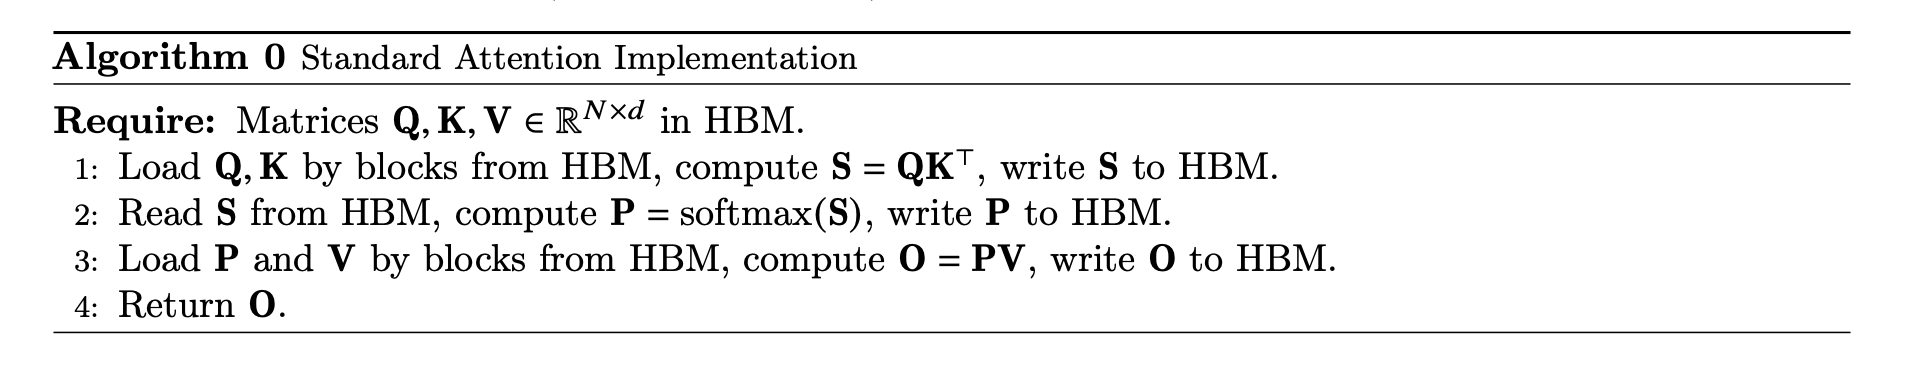
标准的 Attention 算法对于 (1) 需要从 HBM 读取 2 次,写入 1 次,对于 (2) 需要从 HBM 读取一次,写入一次,对于 (3) 需要从 HBM 读取 2 次写入一次。为了减少对于 HBM 的读写,FlashAttention 分块将数据送入 SRAM。但分块后需要计算 softmax,而 softmax 需要读取一行作为分母,因此难点主要在分块算 softmax。
FlashAttention Design
(5) (6) (7) (8)
分块后保存每块的最大值
例如两块分别包含分数
完整递推见 online softmax 与 FlashAttention 版本演进。
论文 Algorithm 1: 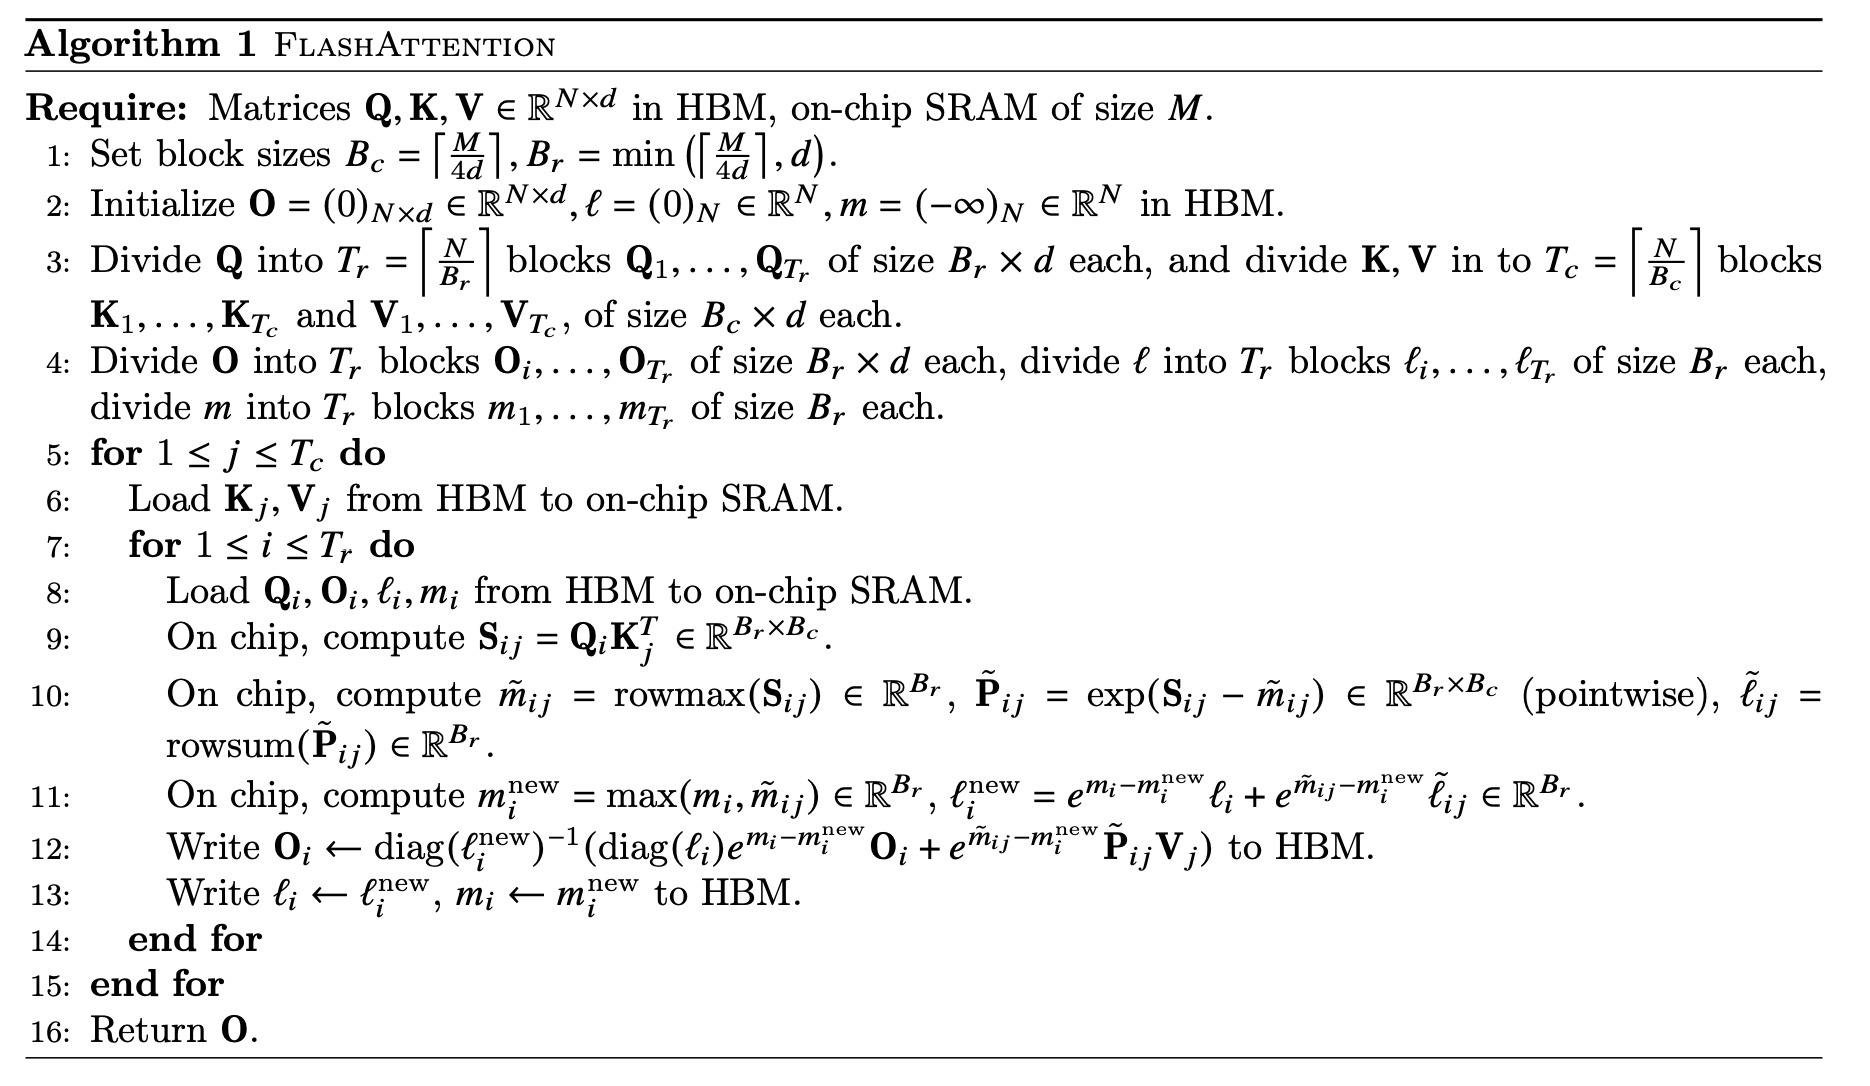
L1: 根据 SRAM 的大小选择合适的分块大小
和 。 L2:初始化一些变量
L3 & L4: 将矩阵
沿着行方向切分成 块,将向量 切成 块,将 沿着行方向切成 块。 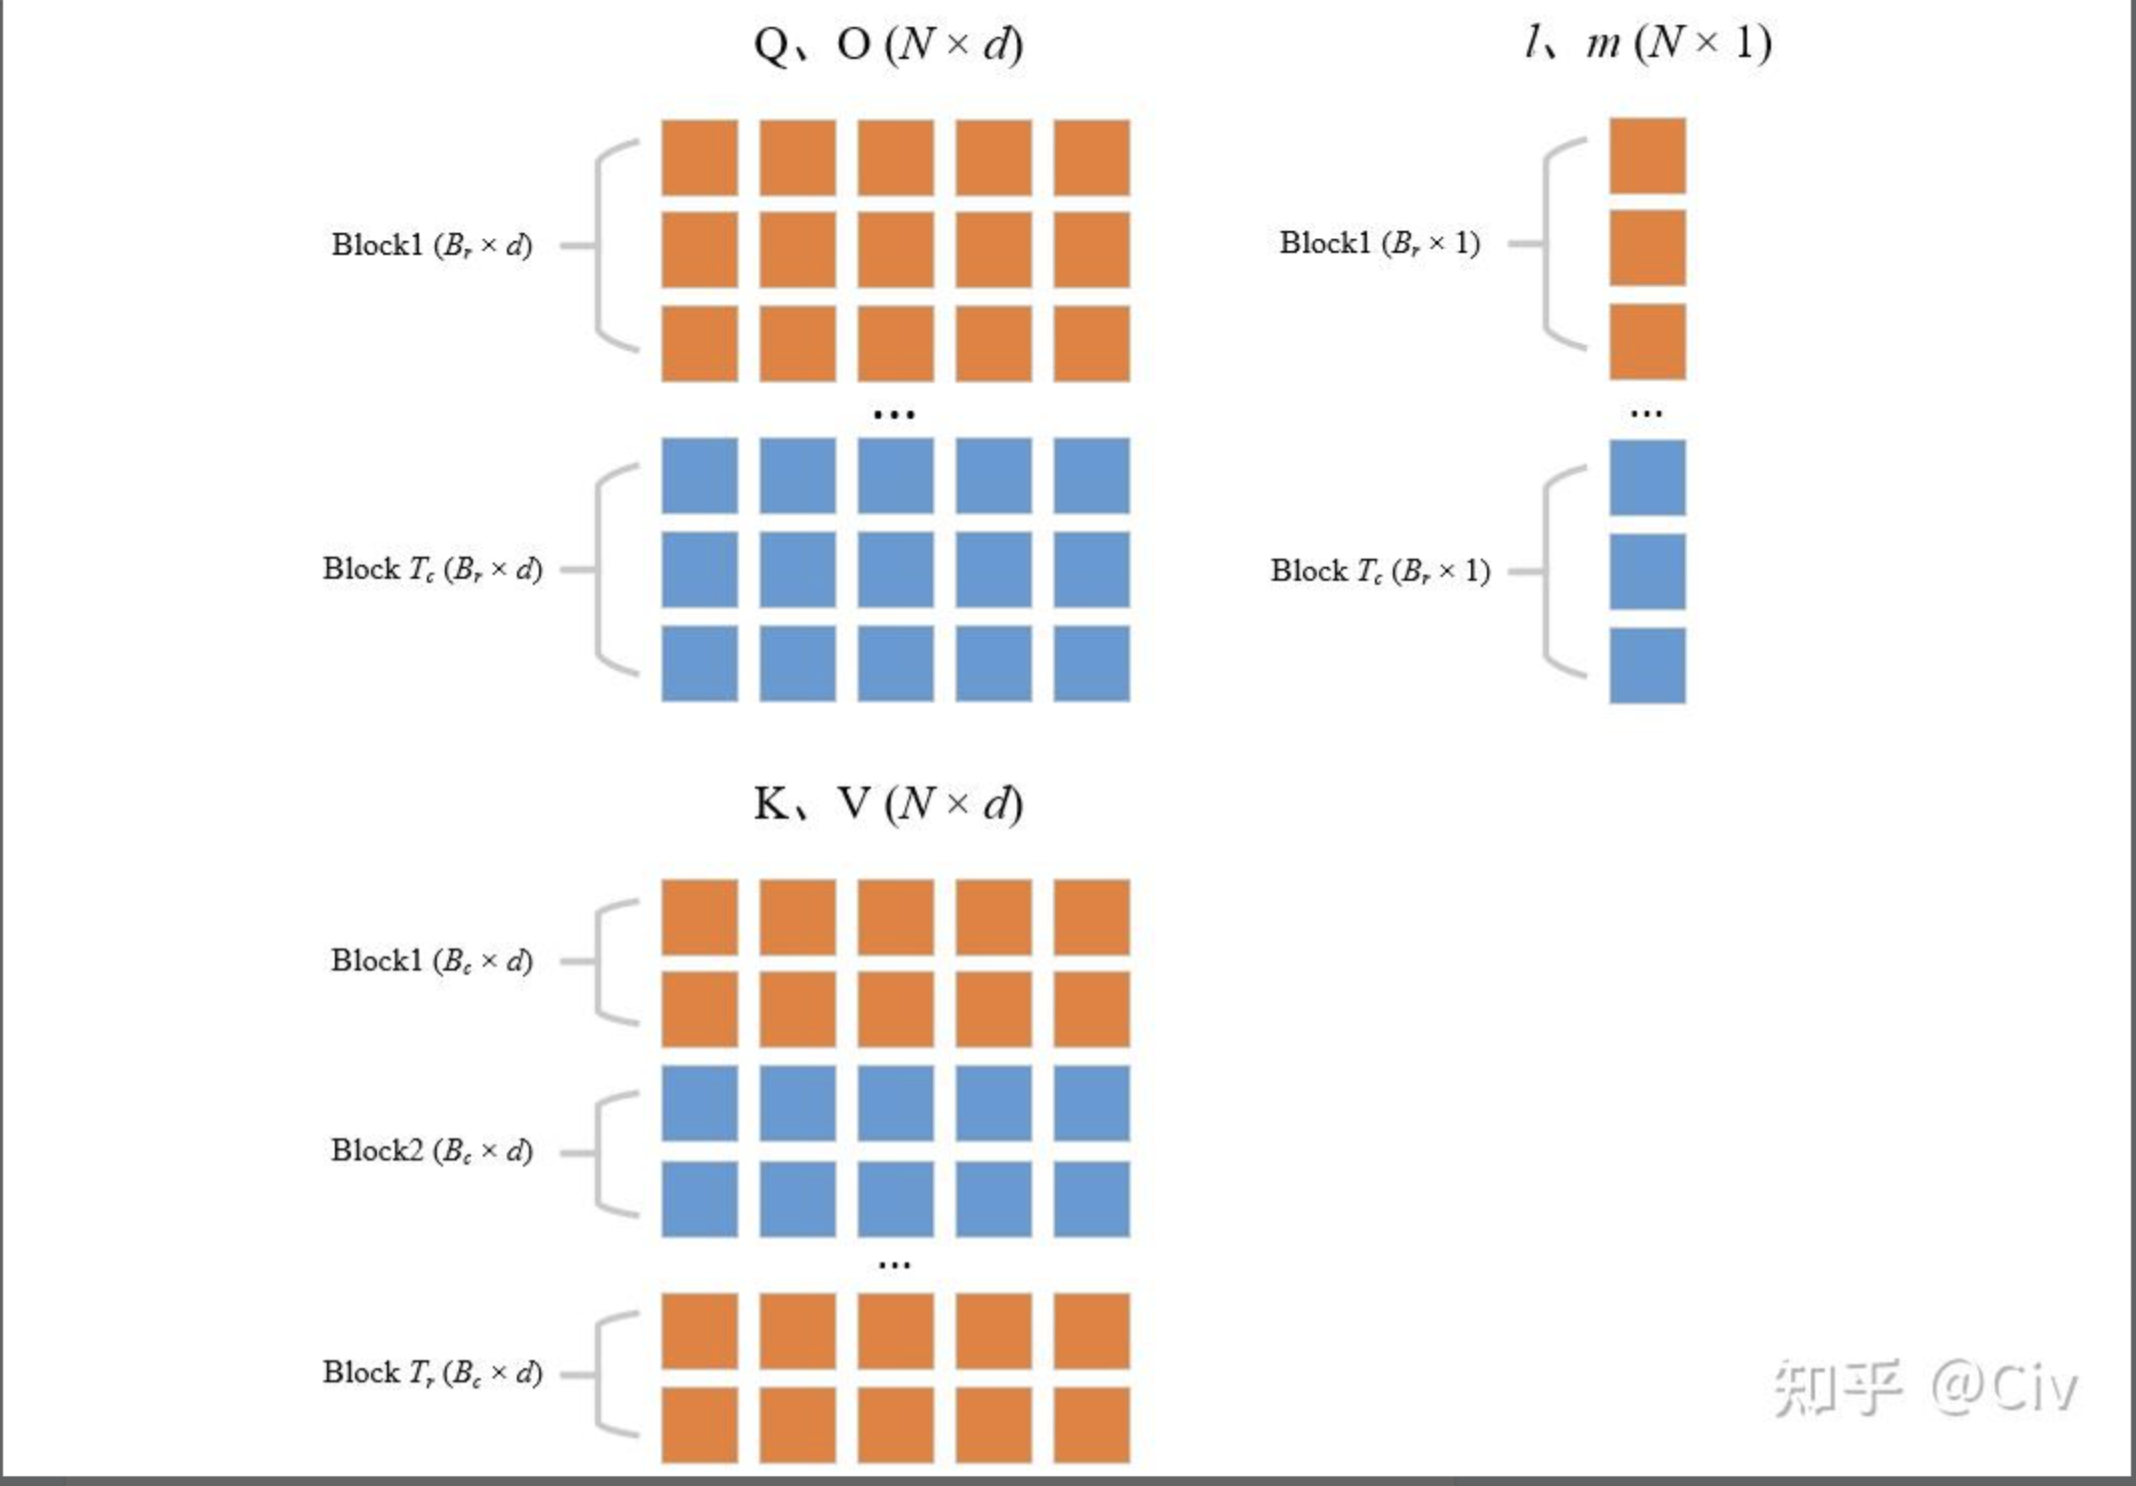
L5: 外循环遍历 K,V
L6: 将遍历的
从 HBM 读入 SRAM。 L7: 内循环遍历
L8: 内循环变量读入 SRAM
L9: 使用当前遍历的
,计算分块的 Attention Score = 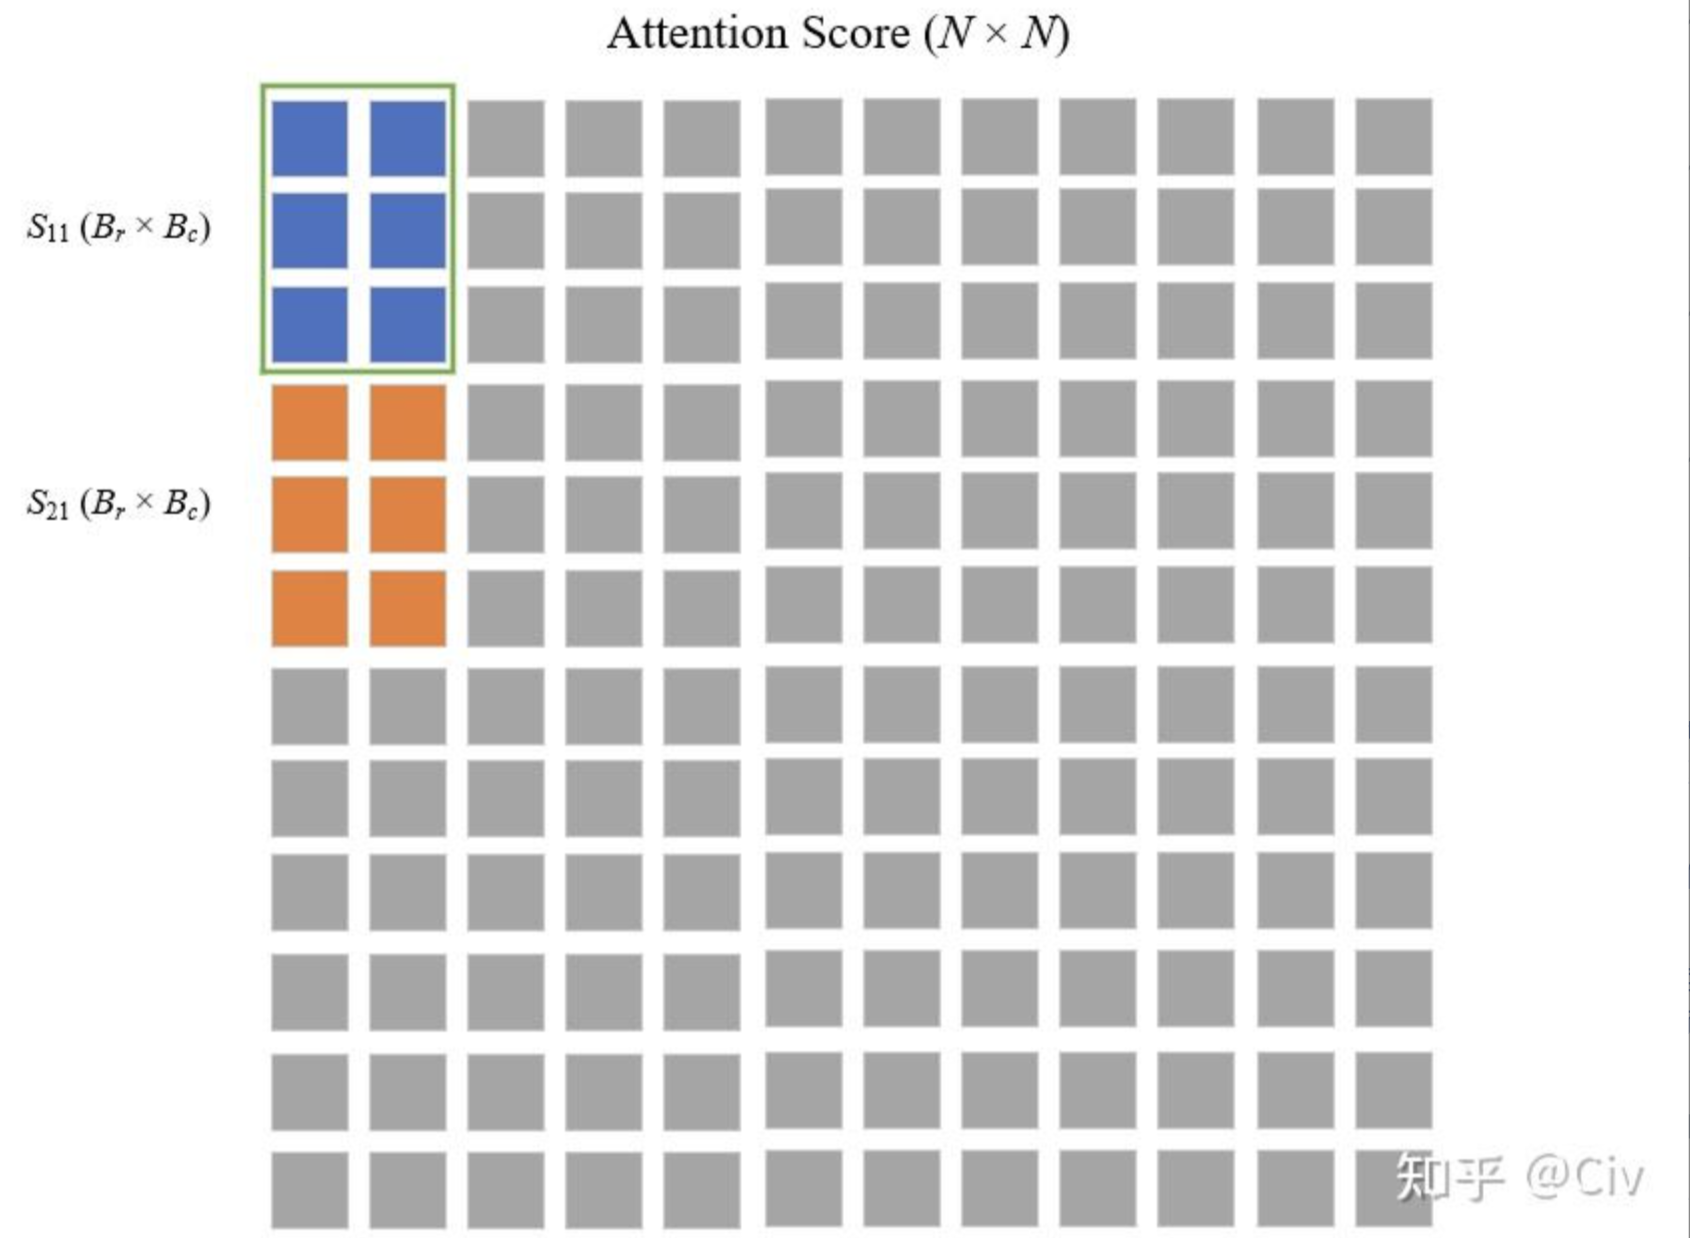
L10:对于分块的 Attention Score,计算每一行的最大值,指数项,求和项
L11: 更新
这些步骤解释前向的分块数据流;原版 Algorithm 1 的 K/V 外循环组织不应直接套用到所有后续 FlashAttention 版本。