Attention Is All You Need
- 论文:原文
Transformer 用 attention 连接序列位置,减少训练时对逐步循环计算的依赖。理解其结构,需要区分 encoder 内部、decoder 历史和 encoder 到 decoder 三条信息路径。
Transformer Architecture
大部分 neural sequence transduction 模型有 encoder-decoder 架构。encoder 原始输入 -> 长度为 n 的机器学习向量,decoder: 编码器输出/解码器输出 -> 长度为 m 序列,是一个自回归的架构。 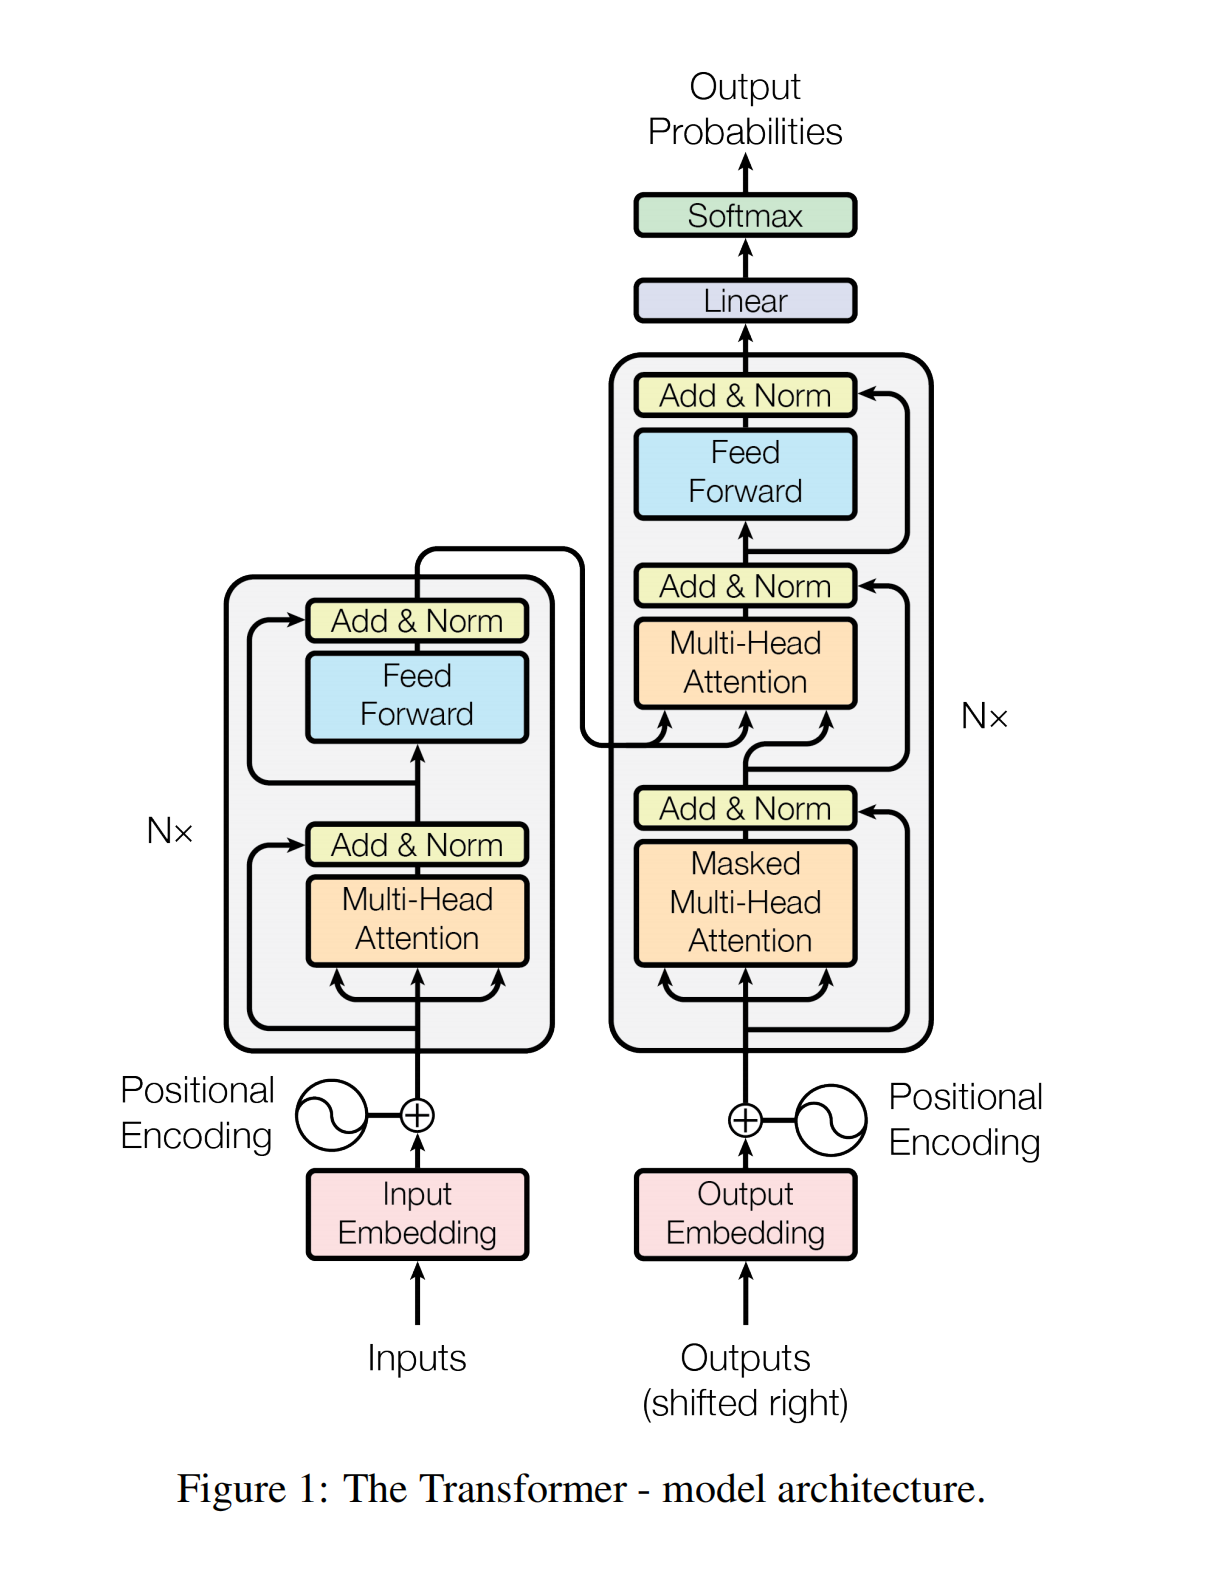
- Encoder(AI 中文转述,原论文 §3.1):原始配置堆叠 6 层,每层先做多头自注意力,再做逐位置的前馈网络。各子层使用残差连接,并在相加后做 LayerNorm;统一的表示宽度为 512。
- Decoder(AI 中文转述,原论文 §3.1):同样堆叠 6 层,在自注意力与前馈网络之外加入面向 encoder 输出的 attention。自注意力使用因果掩码,配合右移的目标输入,预测只能使用已知的历史位置。
Attention
批量计算时,
例如
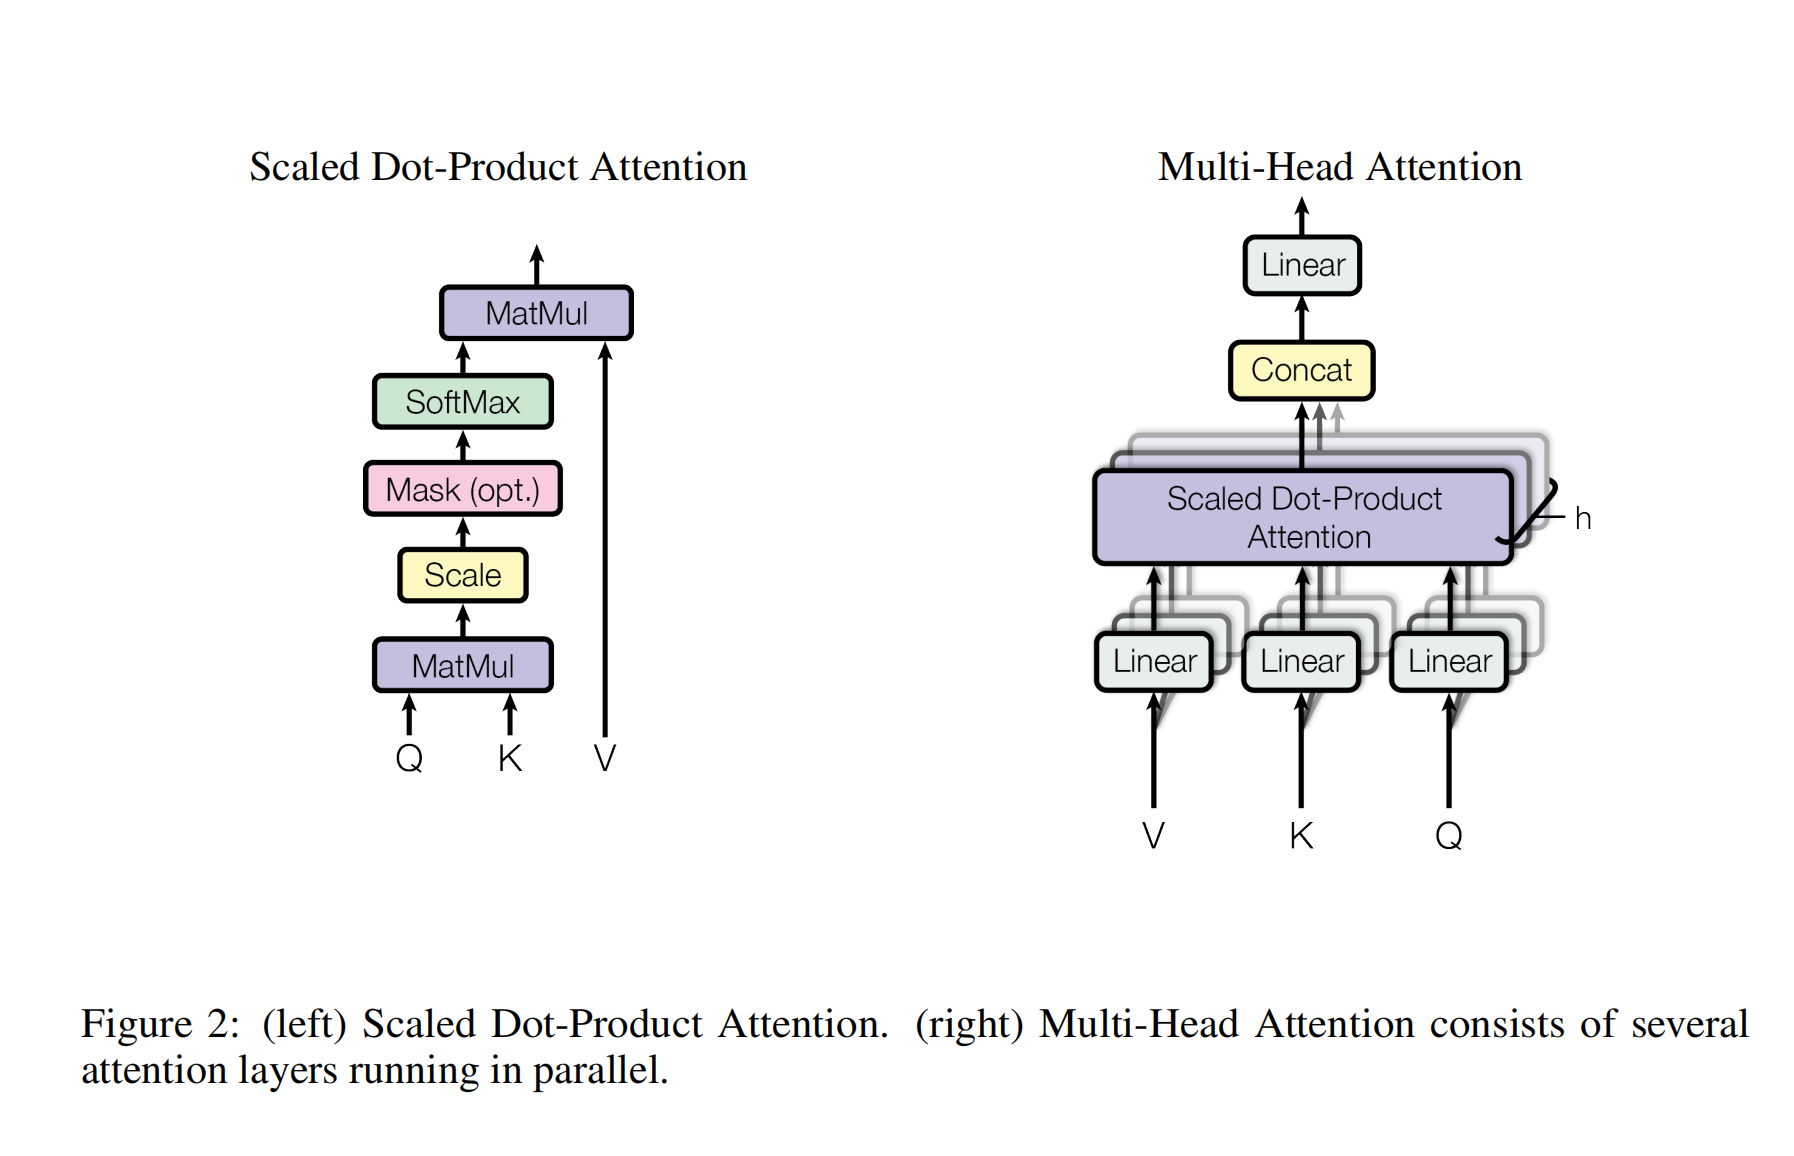
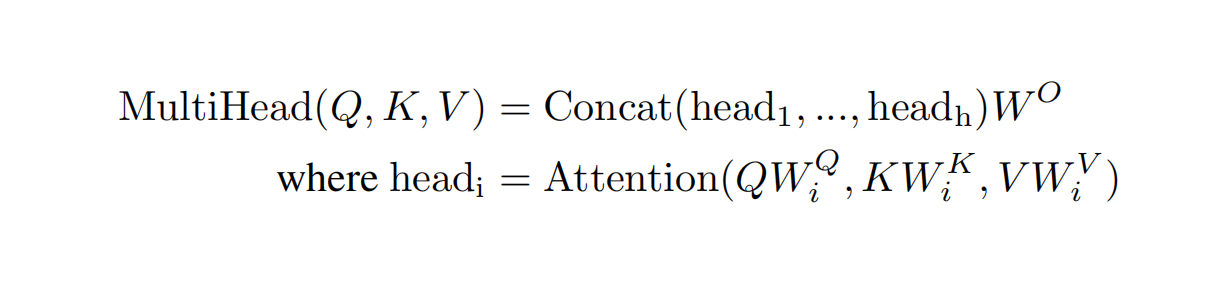
encoder self-attention 的 Q/K/V 都来自 encoder;decoder masked self-attention 使用 decoder 的历史位置;encoder–decoder attention 用 decoder 产生 Q,用 encoder 输出产生 K/V。三者共享计算形式,但可见信息不同。
Positional Encoding
单靠内容相似度不能表达序列的位置顺序,因此模型在输入表示中加入位置编码。注意力的并行计算降低了对循环状态的依赖,但自回归生成仍按输出位置逐步进行。
相关基础笔记:Transformer。论文中的速度与质量结论属于其评测设置,不能推广为所有模型和任务上都更快。