BOLT: BRIDGING THE GAP BETWEEN AUTO-TUNERS AND HARDWARE-NATIVE PERFORMANCE
- 论文:原文
Background
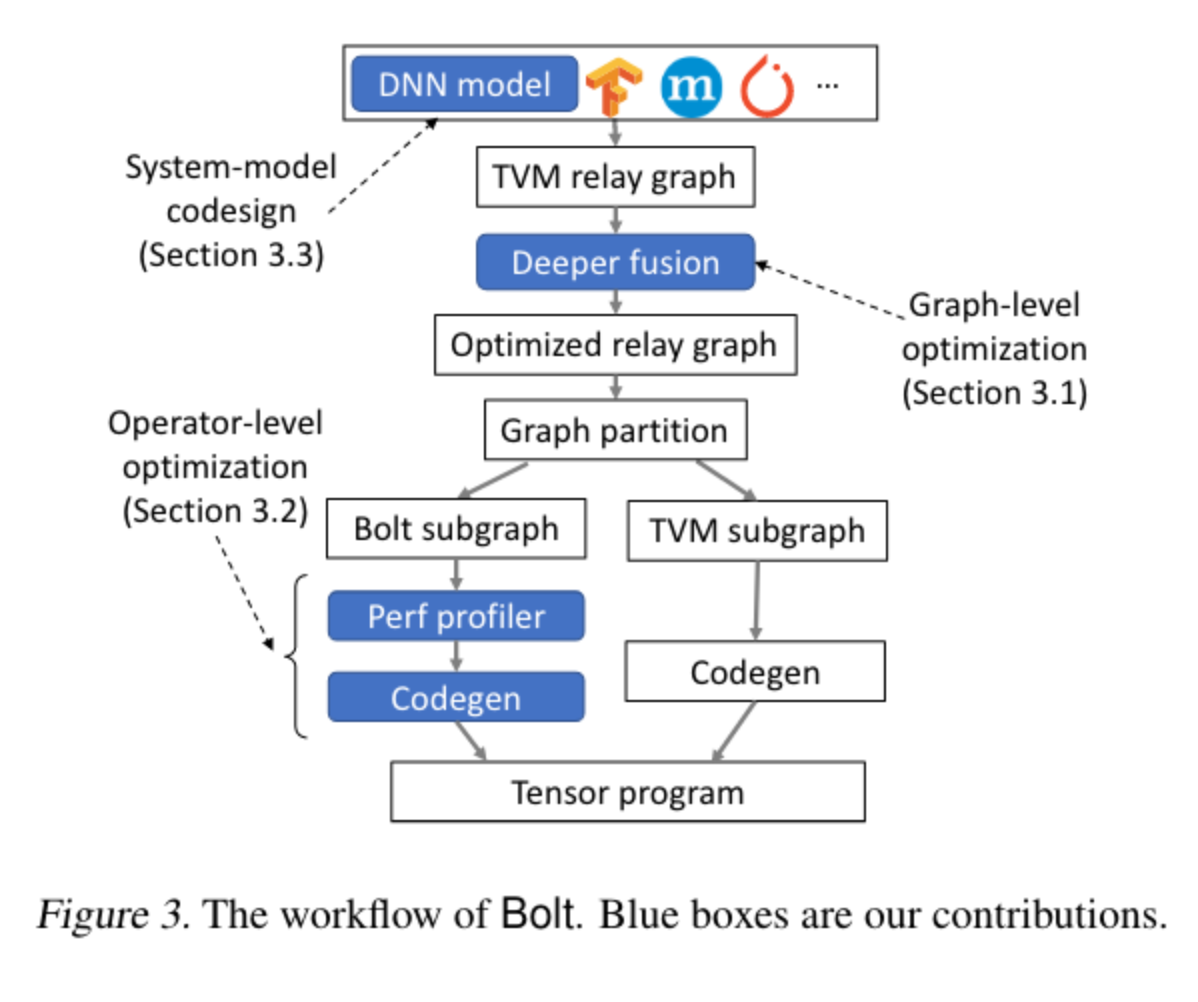
BOLT 从硬件原生模板库中选择可复用、可参数化的计算原语,缩小 auto-tuning 搜索空间。图级优化扩展融合范围,例如 Conv2D + BiasAdd + Hardswish;算子级优化则搜索模板参数并生成代码。两者分别处理跨算子数据移动和单 kernel 的硬件效率。
BOLT Design
Bolt 追随 BYOC 的路径,对张量程序绘制合适子图并将其卸载到 Bolt 进行优化。首先从流行框架的 DNN model 开始,Bolt 首先复用 TVM 前端将其解析为 relay graph。在图上进行计算图优化(deeper operator fusion)和 graph partition。Bolt 接下来执行 hardware-native profilling 去搜索最好的 kernel。最终 Bolt 生成高性能的 CUDA 代码。
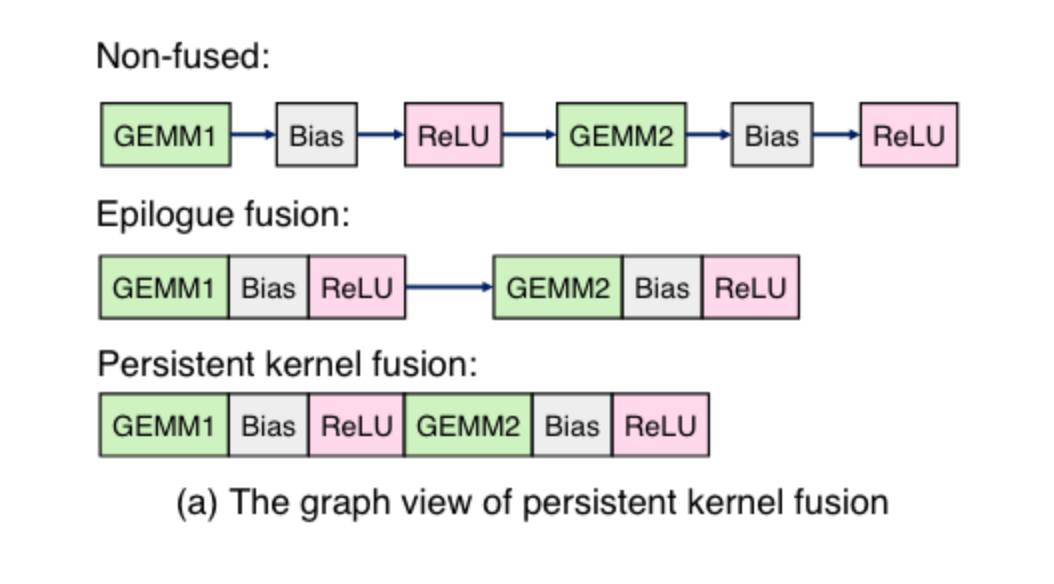
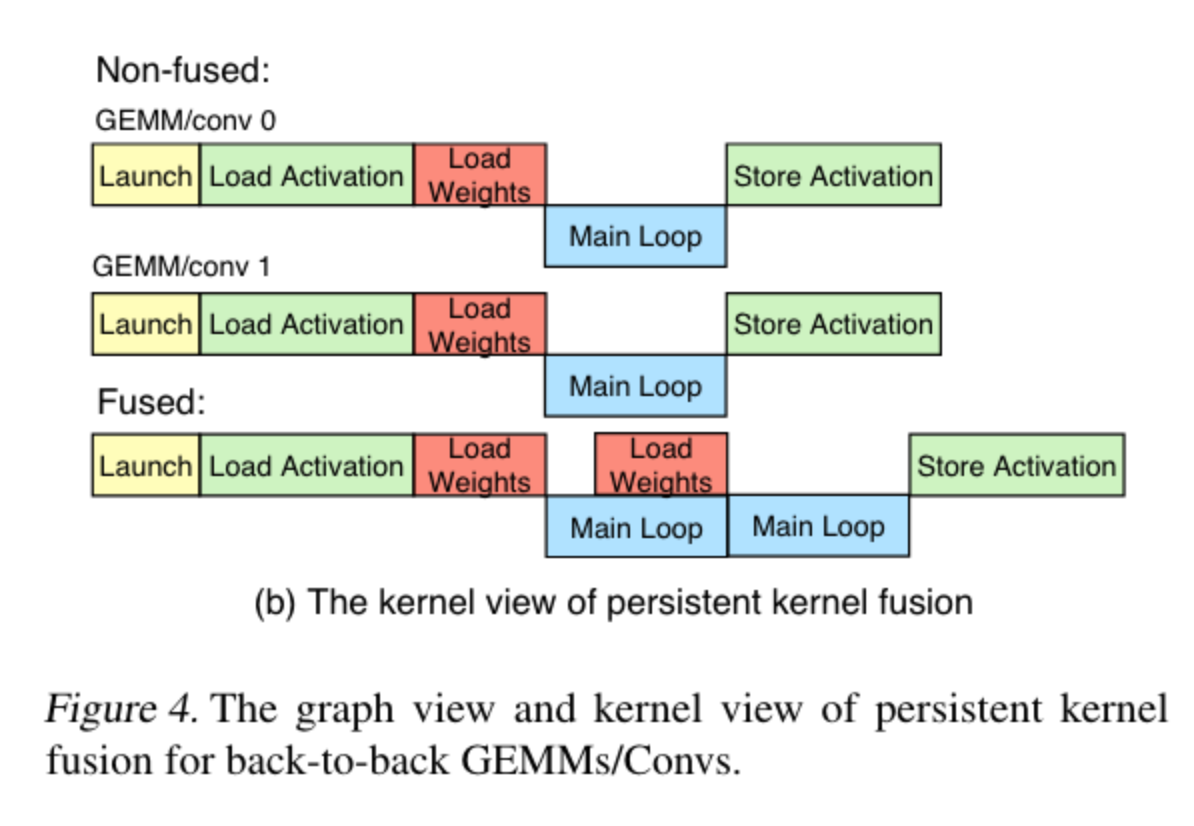
Figure4(a) 展示了使用 epilogue 作为融合的基础,同时融合多个 GEMM 或者 Conv 进入一个单的算子用于提升性能:
- 消除了算子之间的加载和存储内存
- 消除了 kernel lanuch 的时间
- 扩大优化范围以探索更多指令调度的选择
Figure4(b) 展示了 persistent kernel fusion 在 kernel 级别的视角。
Prerequisite: Epilogue fusion. Cutlass 的 epilogue 模式包括:
- element-wise 算子
- 数据类型转换
- 在列上广播向量
- 在列上进行部分 reducation
Persistent kernel 允许将多个 GEMMs 和 Conv 融合到一个算子用来提升性能。
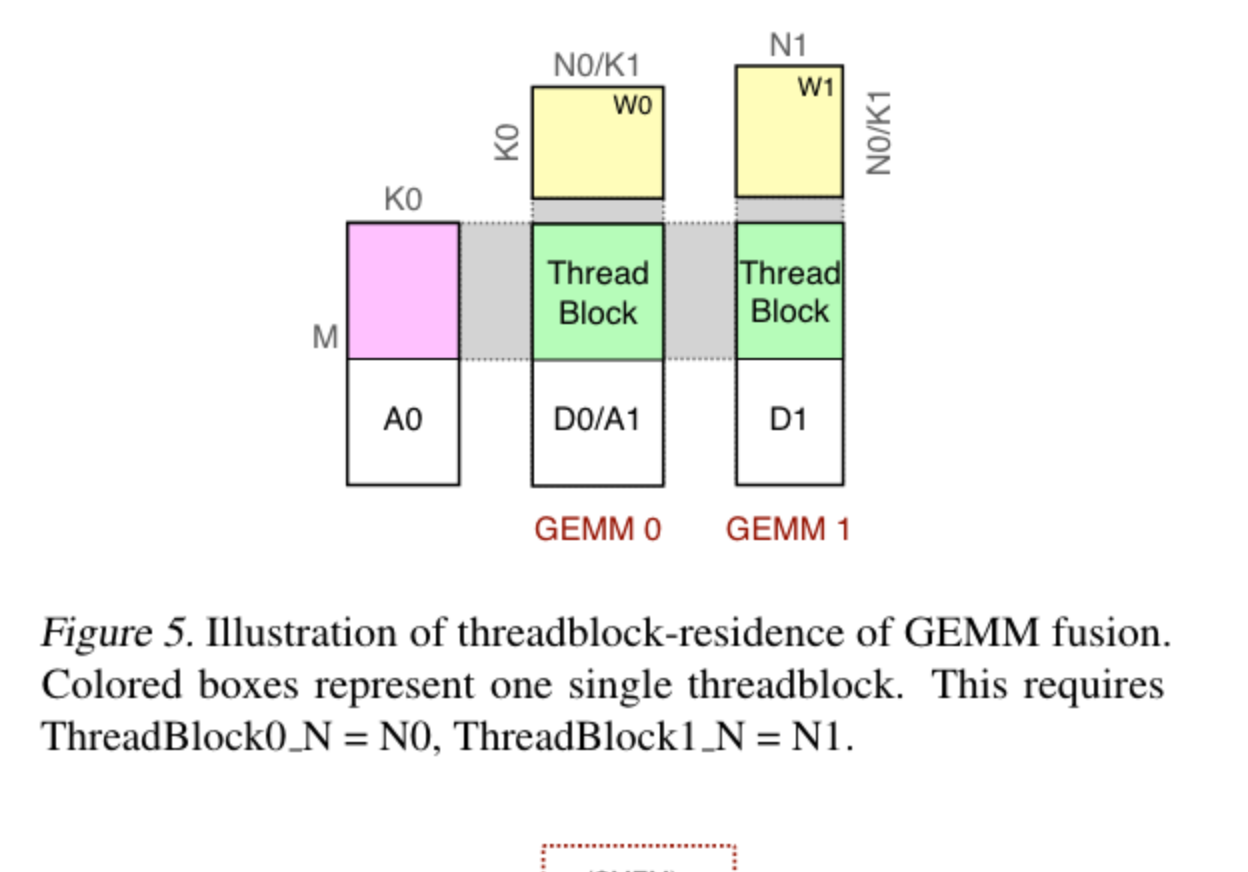
Key property: Threadblock residence. 计算持久化内核融合的挑战在于计算第二个 GEMM/Conv 时不去从全局内存中加载它的 input activation。这就要求第一阶段 GEMM/Conv 输出的每个 threadblock 保留在第二个输入的 GEMM/Conv 相同的线程块中。论文中叫做 threadblock residence。如果不能做到这个,第二阶段的 GEMM/Conv 不得不从全局内存中加载内存,就消除了持久化 kernel 融合的优势。对于 GEMM fusion,要求对于每个算子 ThreadBlock_N = GEMM_N。对于 Conv,要求 ThreadBlock N = Conv output channel。
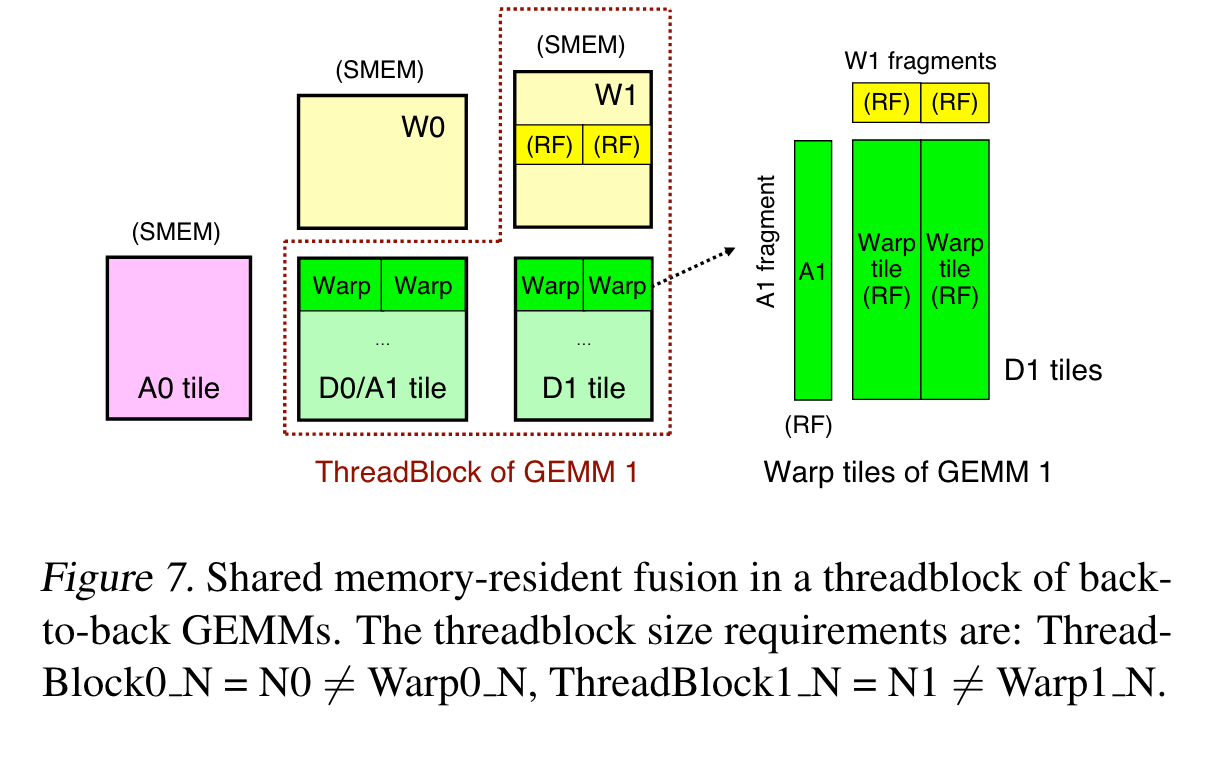
Shared memory-resident fusion. 当 GEMM_N 更大时有更高的 RF 压力,因此使用 shared memory-resident fusion 用于缓解 warp size 的限制。在第二阶段的 GEMM/Conv 需要在 warp 共享时,数据可以暂存在共享内存中。Figure7 展示了一个例子,计算 D1 需要 N 维度的多个 warp tile 流式传输 fragments。因此在 GEMM0 阶段在累加器产生的数据必须从 RF 加载到 shared memory 为了加载 GEMM1。每个 warp 所拥有的数据将被在下一层进行共享。为了能够进行 shared memory-resident fusion,本篇论文实现了一个 smem fragment iterator 可以把 accumulator tile 存到 shared memory 中,之后从第二阶段的 GEMM 中的共享内存中取值。
Bolt 设计了一个轻量级的 performance profiler 用于搜索最好的模版参数。具体来说,Bolt 首先提取 CUTLASS 模版相关的性能参数,包括 threadblock,warp 和 instruction shape, swizzling functor 和 stages 等等。随后确定它们可能的值通过具体的 GPU 体系结构和 Auto-tunner。Hardware-specific guideline 包含以下几个方面:
- Bolt 倾向于使用大的 warp tile 实现更高的 compute-memory ratio
- 每个 threadblock 使用 4 个 或 8 个 warptile 可以在 Nvidia 上取得更好的性能
- 小的问题规模需要小的 threadblock size 从而启动足够的 threadblock 保持 SM 忙碌
- Layout Transformation. 论文所用 CUTLASS 卷积路径采用 NHWC 布局,但不是所有模型都是都使用期待的 layout。代替在 Conv 之前和之后都插入 Layout transformation 算子,Bolt 直接把所有 Conv 算子全部改成 NHWC layout。将输入和最终的输出改成 NCHW。
- Kernel padding. 尽管 CUTLASS 支持 8,4,2,1 的对齐,性能在不同的对齐间依然有巨大差距。论文 §3.2.3 使用 128-bit 向量化 load/store 作为该路径的对齐依据。所以对于 FP 16 最有效的方式是使用 8 个 FP16 元素对齐(16 字节)(128/16)。因此 Bolt 自动将未对齐的张量填充为 8 个 FP16 元素对齐(16 字节)。
Evaluation
从 BERT 和 ResNet-50 这些模型中提取了一些内部算子做 micro benchmark,和 Ansor 的性能做对比。