A Survey of LLM Inference Systems
自回归生成使请求长度、KV 占用与每轮活跃 batch 不断变化。推理系统需要同时安排算子执行、批处理和缓存生命周期,避免单项优化转化为另一处的等待或内存压力。综述
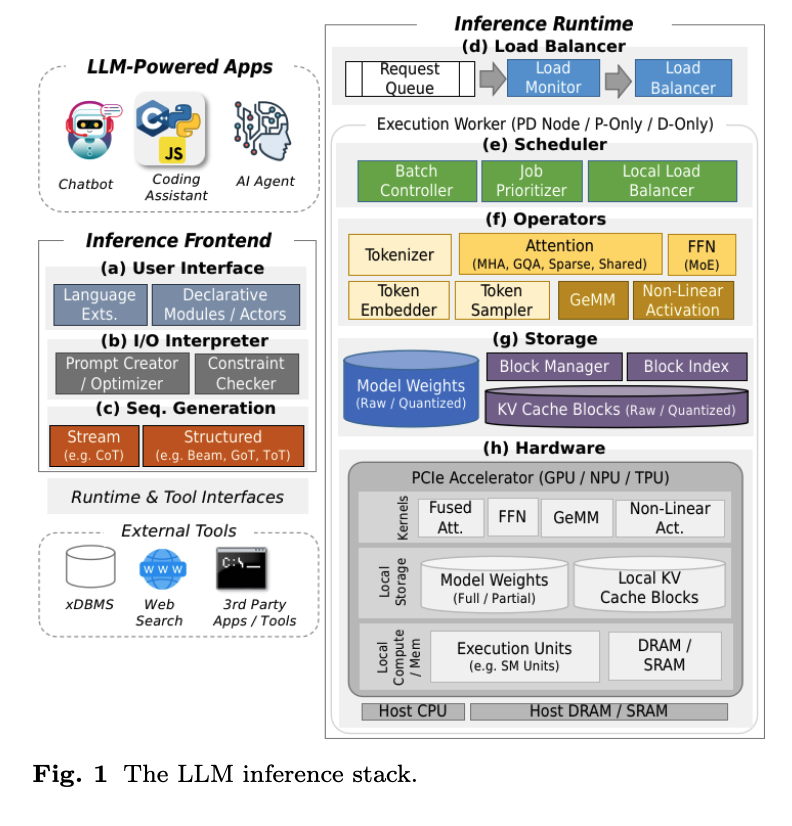
Request Processing
Inference Workflow
请求包含一个初始的前缀
为了生成 output token,每个输入 token 都会被映射到一个高维度的 embedding 通过模型的 embedding 层。这些 embedding 会流经一系列 Transformer 层,各层使用相似的模块结构,但具有各自的参数,从而实现 contextualized(上下文化)。输入序列的最后一个 token 的 contextualized embedding 会被输入到 token sampler 中生成 output token。
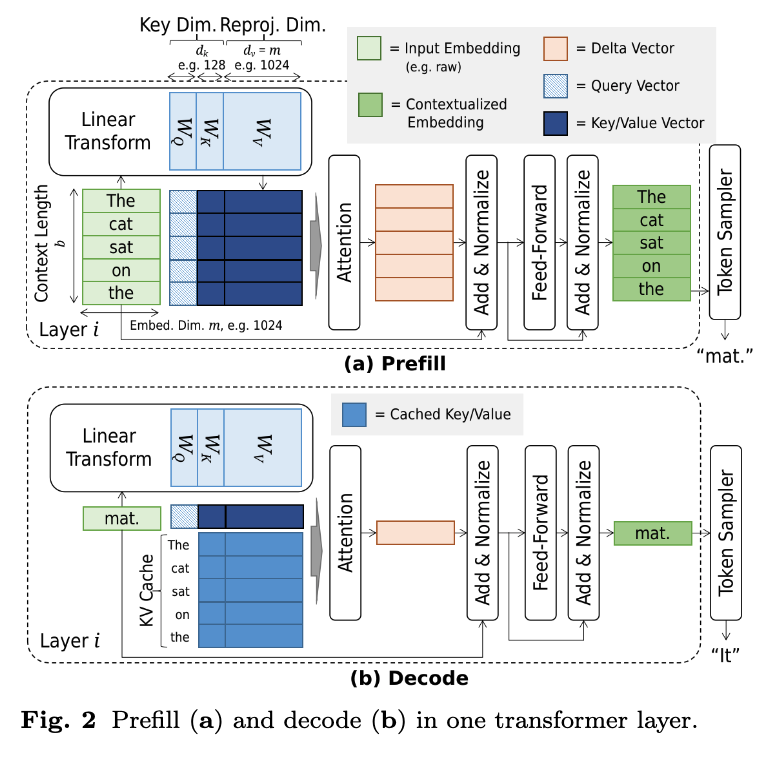
每个 Transformer 中含有一个 Attention 和 FFN,中间还有一个 Normalization。Attention 和 FFN 主要通过将 embedding 乘各种权重矩阵来工作,这些权重矩阵的值通过训练确定。每层为新 token 计算 Q、K、V,历史 token 的 K、V 可复用;随生成继续,KV cache 的行数增长。
Operator
- Attention
针对 token
其中
因果自注意力的 K、V 包含到当前位置为止的 token(
由于 K,V 矩阵在整个请求的生命周期都会使用,因此它们会保存在内存中,通常被称为 KV Cache。
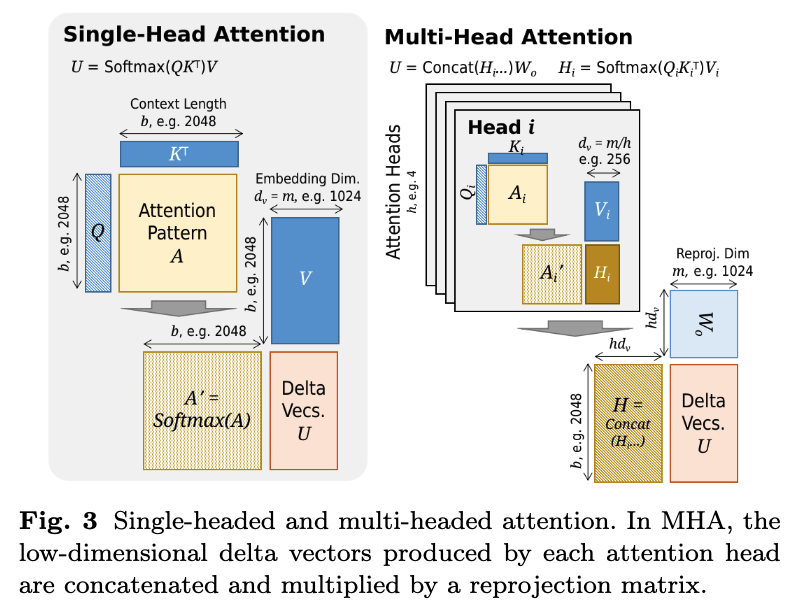
Prefill and Batch. 对 prefill 阶段,所有 prompt 被垂直连接成为单个输入矩阵
其中
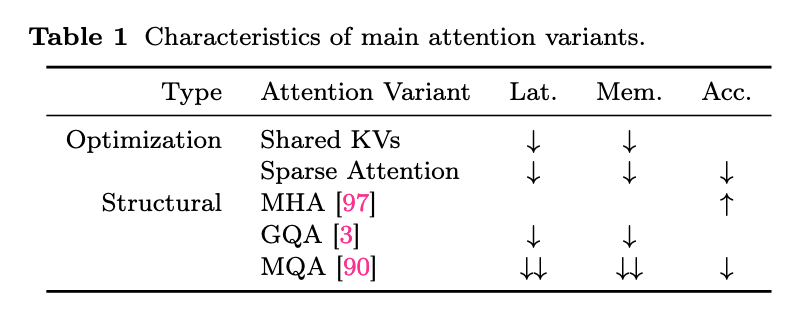
Attention Variants. 对于 long prompts 的请求,需要大量解码轮次,K,V 的行数可能会非常长。
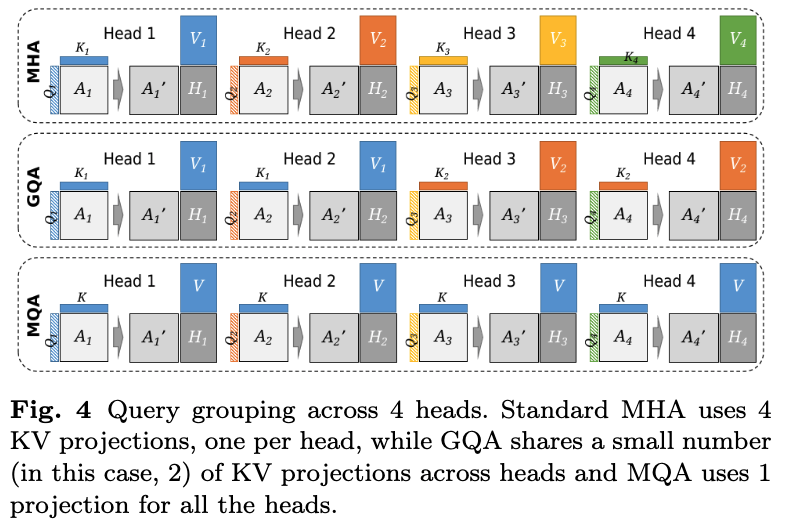
- MHA:垂直分割
, , 并行化公式(1)和(2)。 - 分组注意力:让多个 query 头共享 KV 头,以减少 KV 投影和缓存,参考图(4)和表(1)。
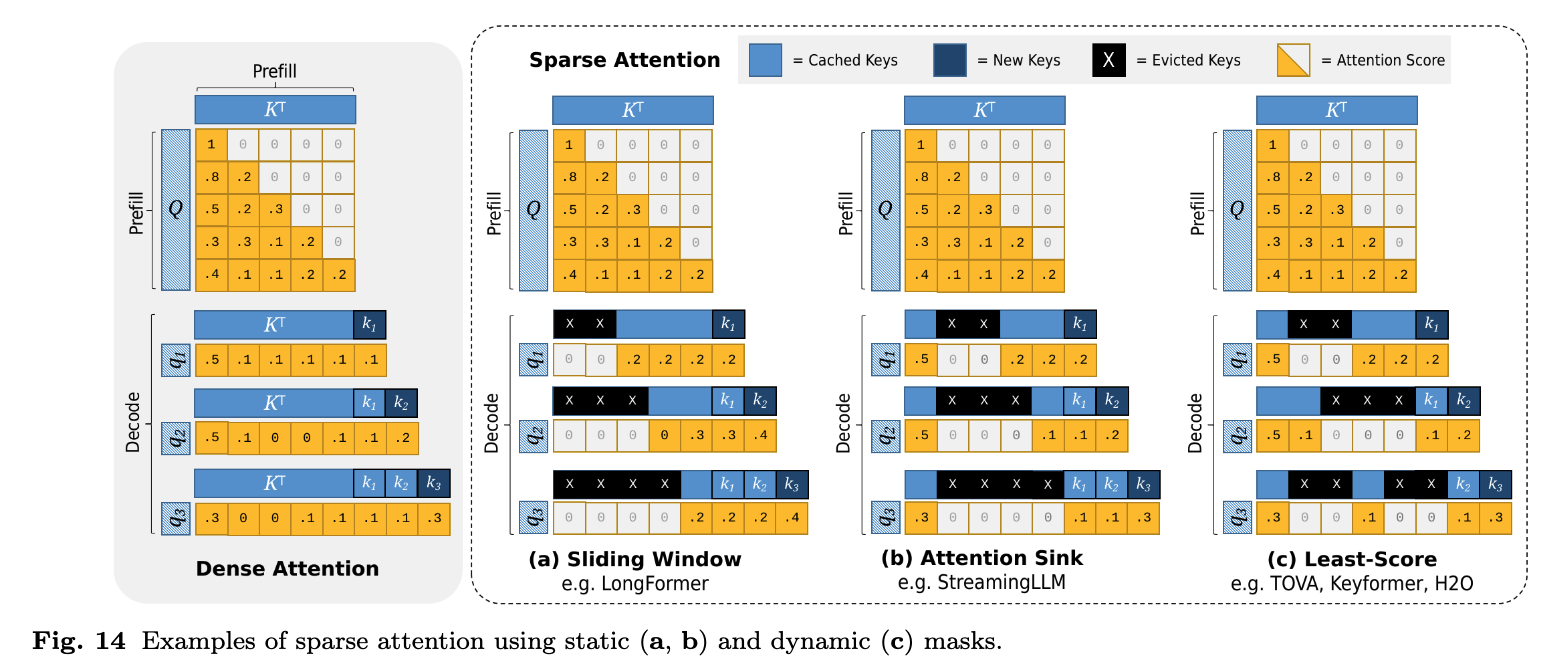
- 稀疏注意力:通过仅计算某些键的注意力模式来降低计算成本。
- 共享注意力:通过在多个输入之间共享注意力模式来降低内存和计算成本,这些输入可能属于单个请求(beam search)也可能属于多个请求(system prompt),该技术通过仅计算一次共享 token 的注意力来降低计算成本。
- Feed-Forward Network
给定嵌入向量
计算和内存成本与参数大小成正比,但与注意力机制不同,注意力机制的成本会根据 KV Cache 的大小变化,而 FFN 的成本对于所有输入都是相同的。
Mixture-of-Experts. 在 MoE 系统中,FFN 被一组较小的网络取代,每个网络称为一个专家。门电路决定使用哪个专家来处理给定的输入。每个 token 只激活部分专家,使激活计算量小于执行全部专家的成本;专家尺寸不必小于 dense FFN。MoE 系统的大部分工作集中在专家架构、门电路设计、专家的动态加载以及专家计算的硬件优化上。在分布式环境中,还需要考虑专家的布局和负载均衡。
- Token Sampling
Token Sampling 是指在生成文本时,从模型给出的概率分布中选择下一个 token 的策略。模型会为词汇表中的每个 token 计算一个概率,采样策略决定了如何从这些概率中挑选出下一个词。这不仅影响生成文本的流畅性和相关性,也决定了文本的多样性和创造性。
给定上下文
Sequence Generation
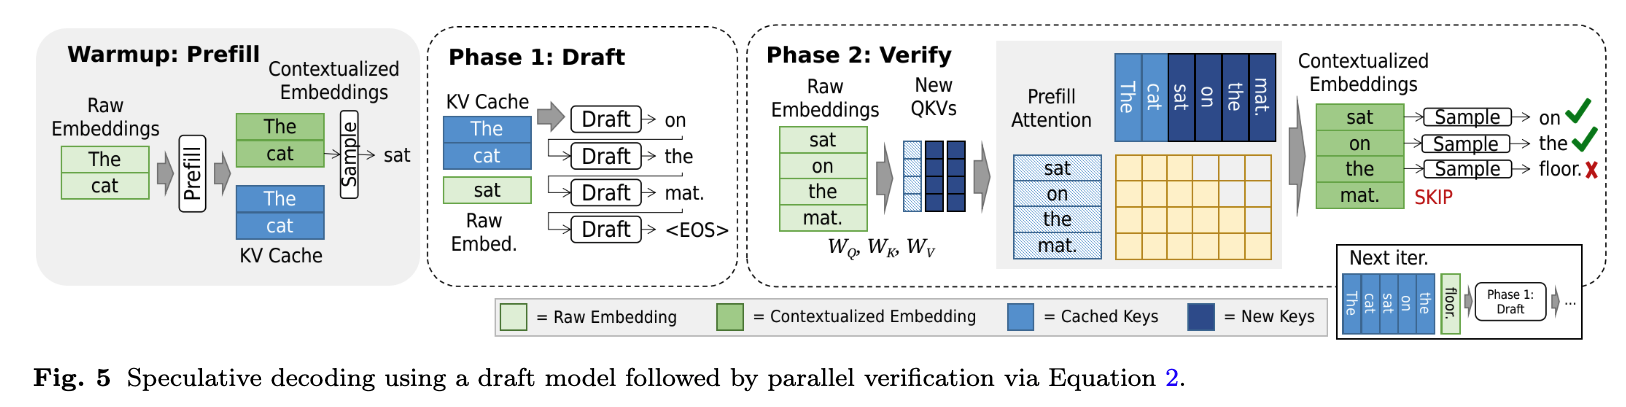
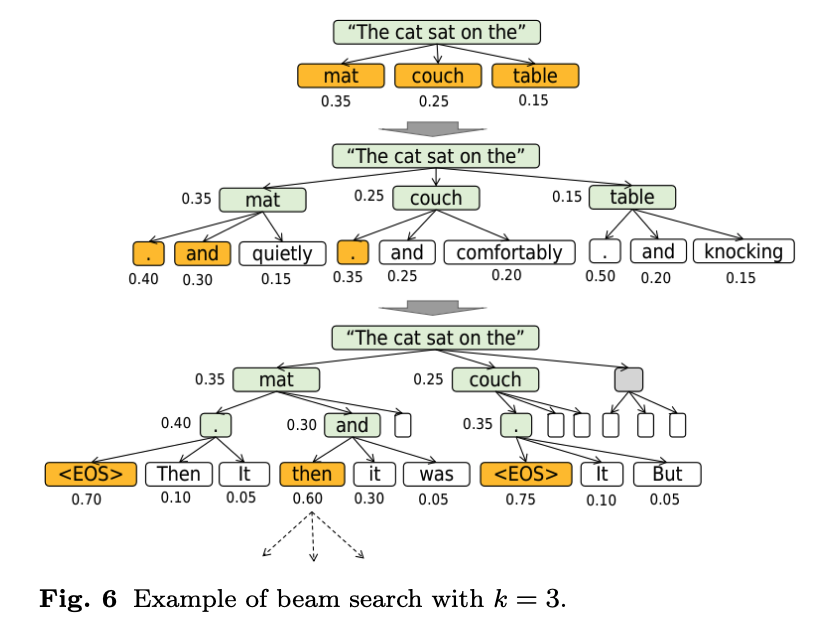
为了生成完整的输出序列,可以将部分生成的序列递归地反馈到模型中,以流式方式生成下一个标记,一旦达到终止条件(例如,生成终止标记)就停止。但是,提示中的细微差异,例如
Model Optimization and Execution
Kernels
- Attention Kernels
Blockwise Attention. 为了提高核心利用率,
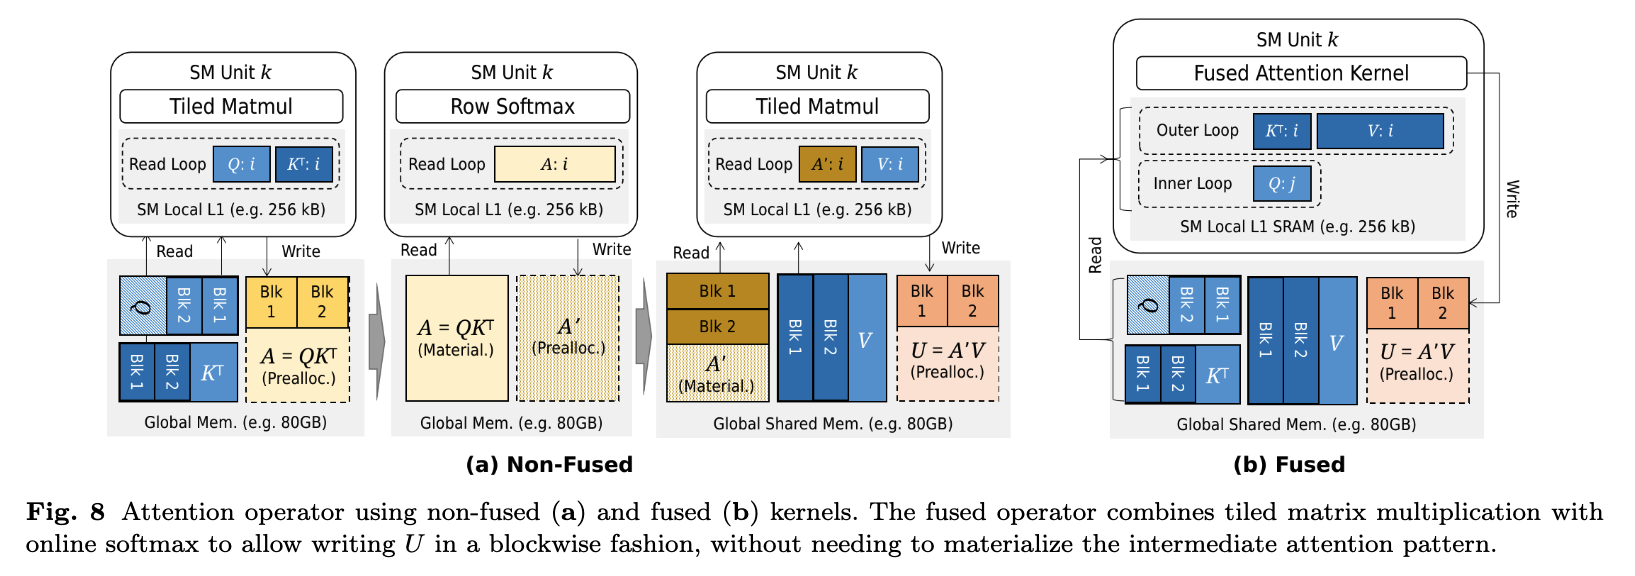
Distributed Attention. Ring Attention
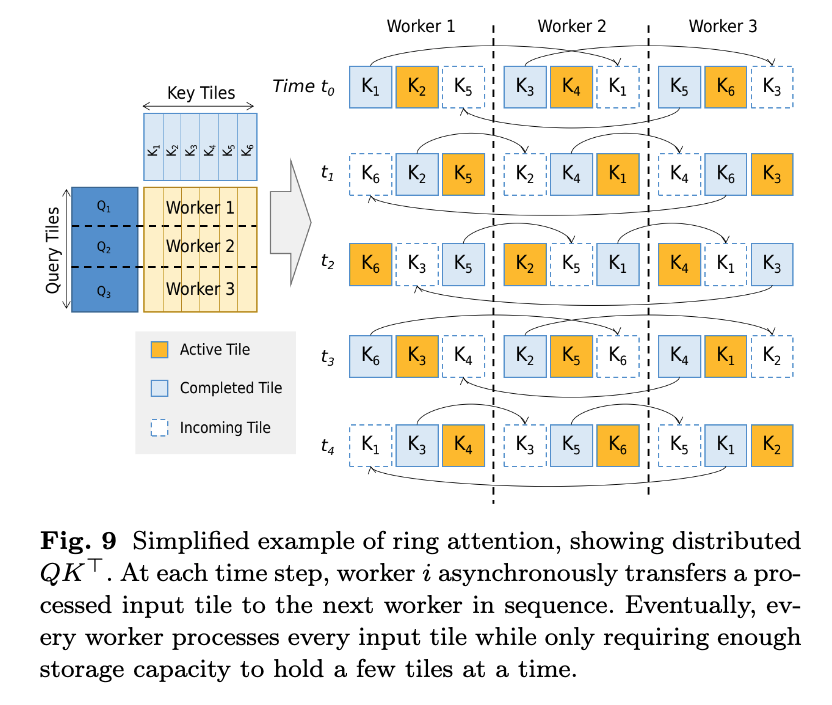
- Other Kernels
FFN 的
对于其他算子,LightSeq 将连续的非 GeMM 操作组合到单个融合内核中,从而生成多个用于
除了融合内核之外,DeepSpeed-Inference还利用 CUDA Graphs 通过一次调用启动多个内核。
Batching
在计算注意力模式之前,将输入向量乘以
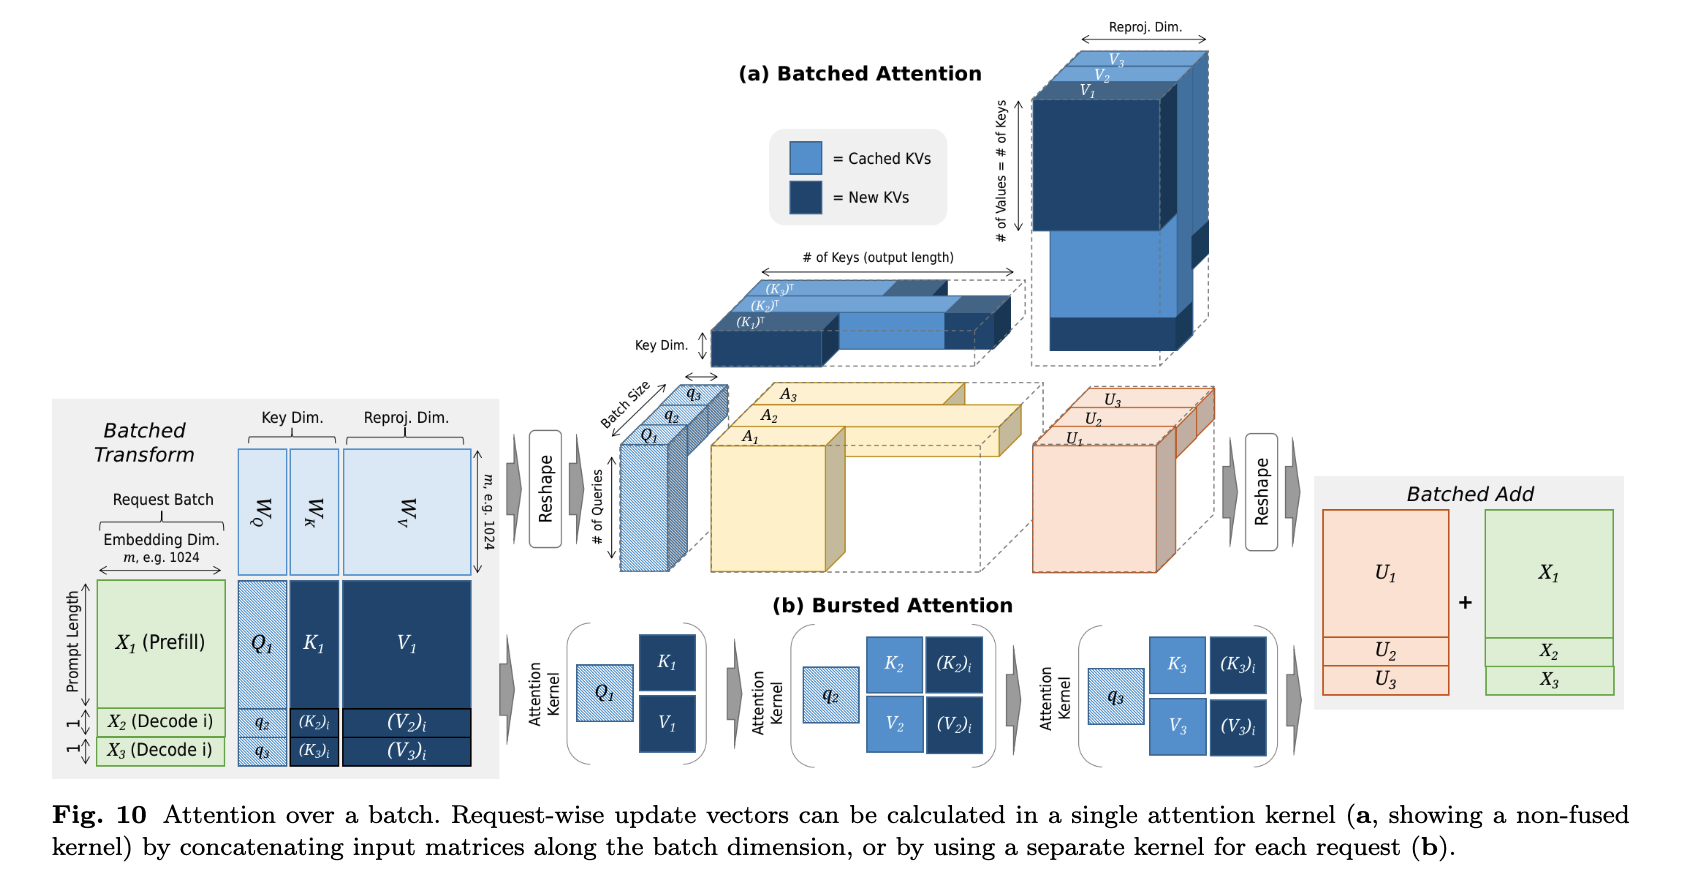
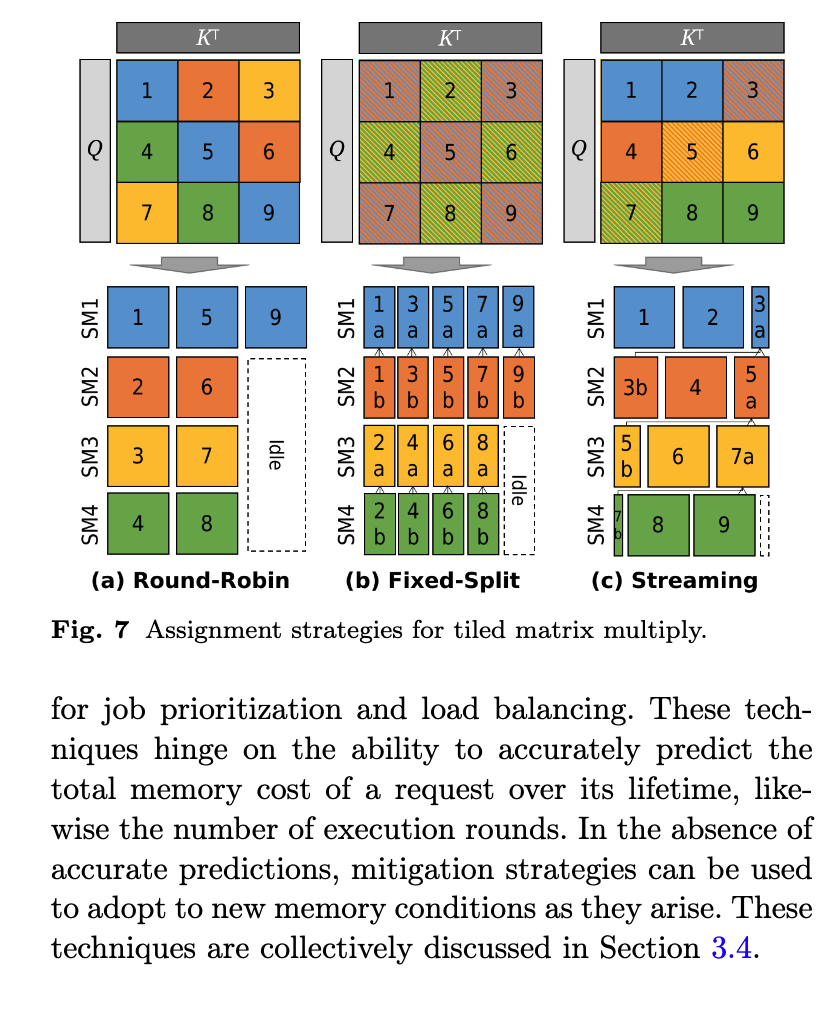
如果批量注意力算子的输入不均匀,也就是说,每个请求的查询矩阵和键矩阵的长度或宽度不相等,那么计算矩阵乘积可能会导致处理器核心因矩阵稀疏性而利用不足。另一方面,bursting 可以避免稀疏矩阵,但需要单独启动内核,每个请求对应一个内核(图10(b))。
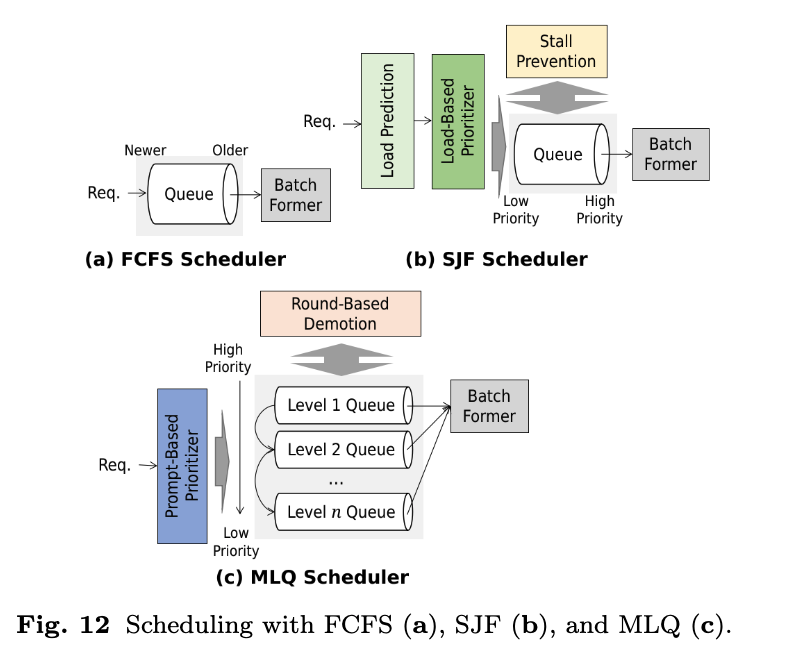
Dynamic Batching. 在静态批处理中,批处理的请求会被一起执行与返回,因此即使某些请求可能比其他请求更早达到终止状态,它们的延迟看起来也相等。Continuous Batching 通过在迭代之间动态插入和删除批处理中的请求来解决此问题,从而提高了 GPU 利用率。
(1)
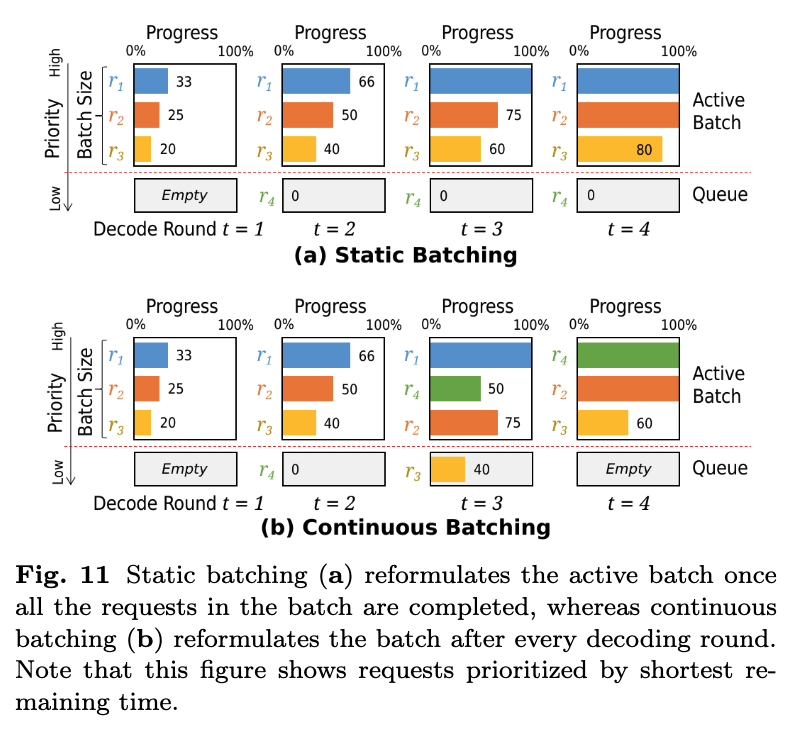
Memory Management
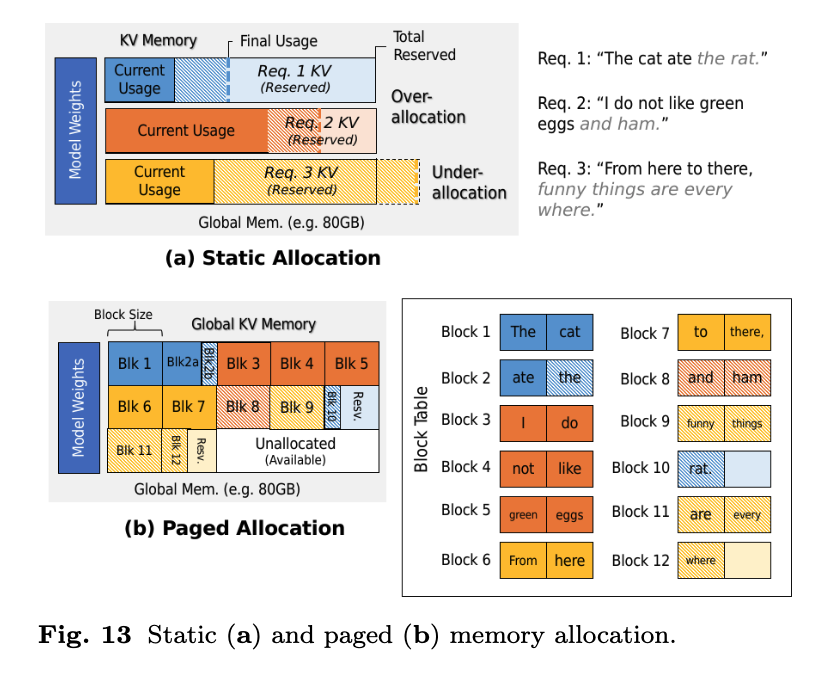
如果不考虑
与静态预分配不同,动态的基于分页的内存管理(
Paged-Based Memory Allocation
由于
Memory Manager. 内存管理器负责页面的创建、删除和查找。为了跟踪页面块地址和内容(即映射到页面中存储的 KV 条目的 token 及其在序列中的位置),可以使用页表来列出每个页面的地址和内容(图 13)。在 vLLM 中,GPU 内存作为内存容器,内存管理器和页表在主机上实现。
主机维护块分配与逻辑映射,并将 block table 作为元数据提供给 GPU kernel;kernel 在设备侧查表定位 KV,不是每次访存都向 CPU 发起查找。块池内的分配也不等于每次调用底层 GPU 分配器。代价来自查表、分支和不连续访存。vLLM kernel 文档
vAttention 则利用虚拟内存映射保持 kernel 可见的连续地址,在背后按需提供物理内存,从而允许使用非分页 attention kernel;其代价转为映射管理与相关同步。vAttention §3–4
Block Sharing. 为了实现
Eviction and Offloading
缓存驱逐(
被驱逐的条目可以通过基于部分
Long Context Eviction. 驱逐特定的缓存条目可以为更重要的条目腾出空间,同时最小化对输出质量的影响。
(1)
(2)
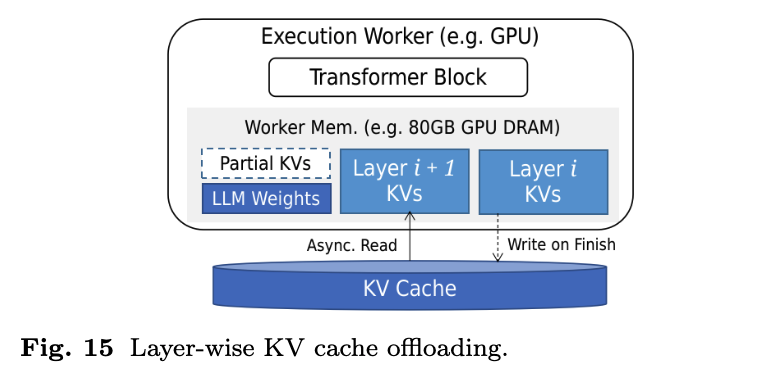
Long Context Offloading. 或者,长上下文卸载可用于将大型
(1)
(2)
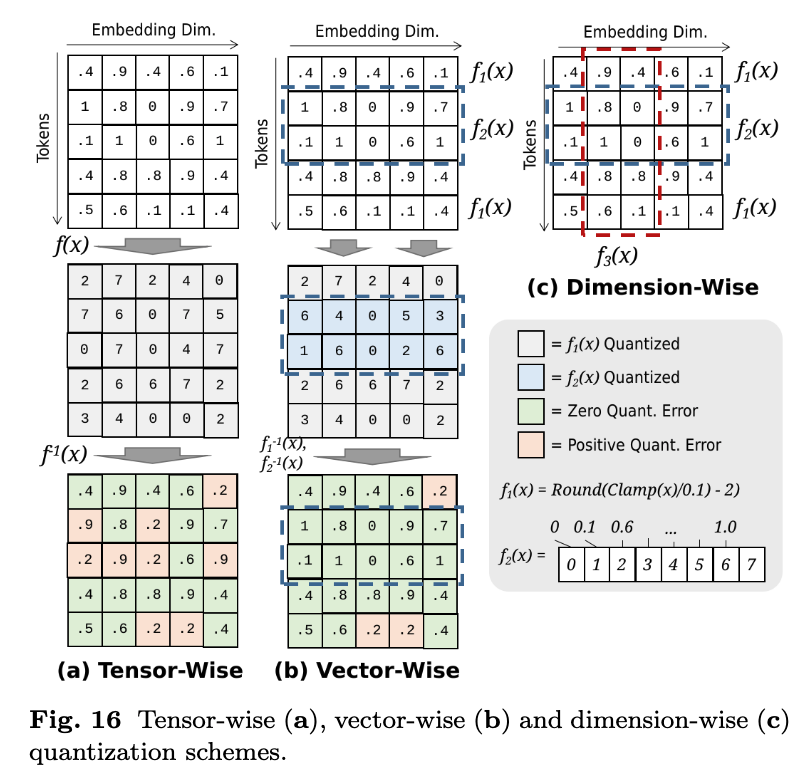
Quantization
量化(
Quantizer Design. 对于均匀和非均匀量化器,设计通常旨在最小化量化前后的损失函数,例如均方误差。对于采用
Quantization Schemes. 由于模型权重往往需要大量存储空间,(1) 对权重矩阵进行张量级量化(
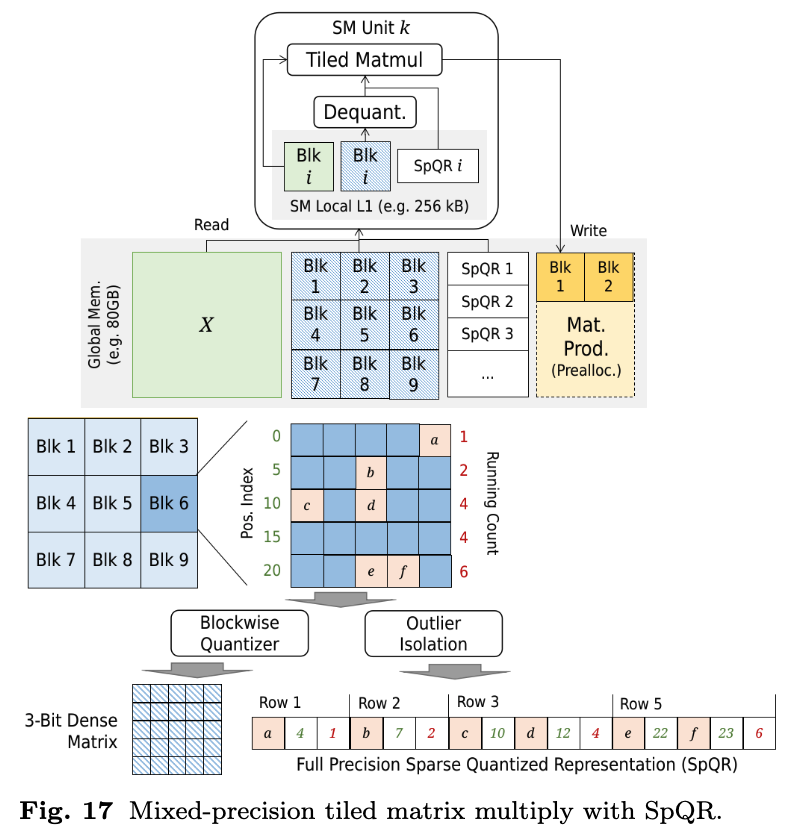
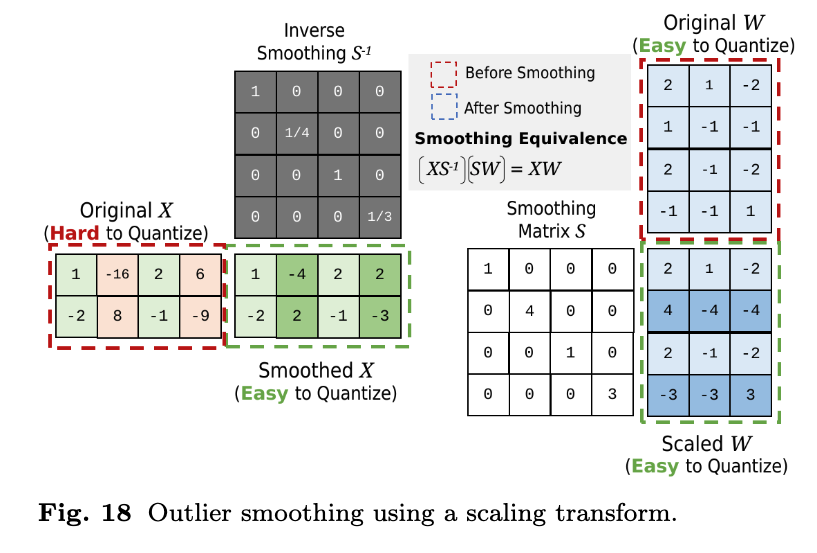
Outlier Protection. 异常值已被证明会不成比例地影响模型质量。(1) 混合精度保留(
Cache Persistence
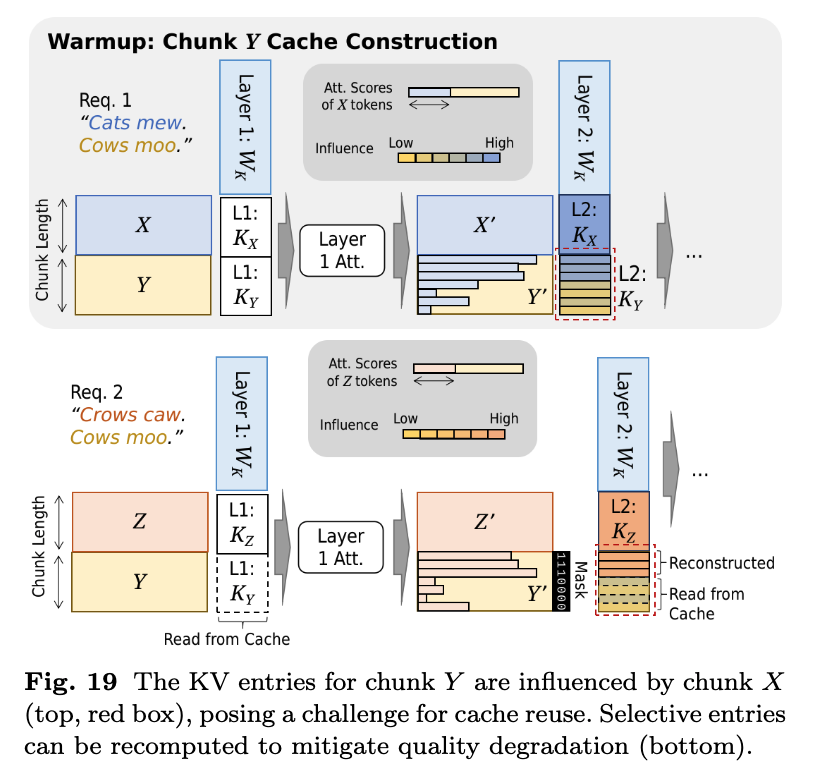
缓存持久化(
(1)
Inference Systems
在 LLM 推理系统中,各种请求处理、执行和内存管理技术被结合起来,以支持高效和高质量地处理通用 LLM 工作负载,或针对更具体的应用。一个完整的推理系统由前端(