ReplaySSM: Cache SSM Inputs, Not State
SSM 将历史压缩成固定大小的 recurrent state,避免了 Transformer KV Cache 随上下文增长的存储开销。但固定大小并不意味着更新便宜:常规 decode 每一步都要从 HBM 读取状态、更新状态、计算输出,再将整个状态写回。ReplaySSM 保留一个较早的 checkpoint 和最近一小段 SSM 输入,将完整状态的写回推迟到窗口刷新时,并利用这些输入直接计算输出、支持投机回滚。论文 v1,§2–6
Background
以一个 Mamba-2 value head 为例,状态矩阵
这里沿用论文记号,将博客中的
在混合模型中,少量 attention 层也不一定主导延迟。例如 Nemotron-3-Super 有 40 层 Mamba-2、8 层 attention,论文测得 SSM 到约 100K 上下文仍是显著开销;更长上下文时,持续增长的 KV Cache 流量才会使 attention 更突出。这是具体模型的结果,不能推广为所有 SSM decode 都受带宽限制。
状态压缩还带来两个与投机解码有关的困难:
- 缺少低成本回滚路径。 KV Cache 可以缩短有效前缀,丢弃被拒绝 draft 的条目;只有当前 SSM 状态时,没有对应的历史条目可供截断。论文中的常规 vLLM 投机路径为每个 draft 位置保存完整状态快照,拒绝后恢复对应快照,增加了状态写入与显存占用。“SSM 不能回滚”应理解为这种表示缺少便宜的回滚机制,而非数学上绝对不能恢复状态。
- 验证需要每个位置的输出。 常规递推沿
个 draft 逐个更新状态,不能只计算窗口末尾的状态就完成验证。但顺序依赖也不等于所有等价算法都无法并行;ReplaySSM 正是通过改变输出的计算方式,避免逐个物化这些中间状态。论文 §3、§5
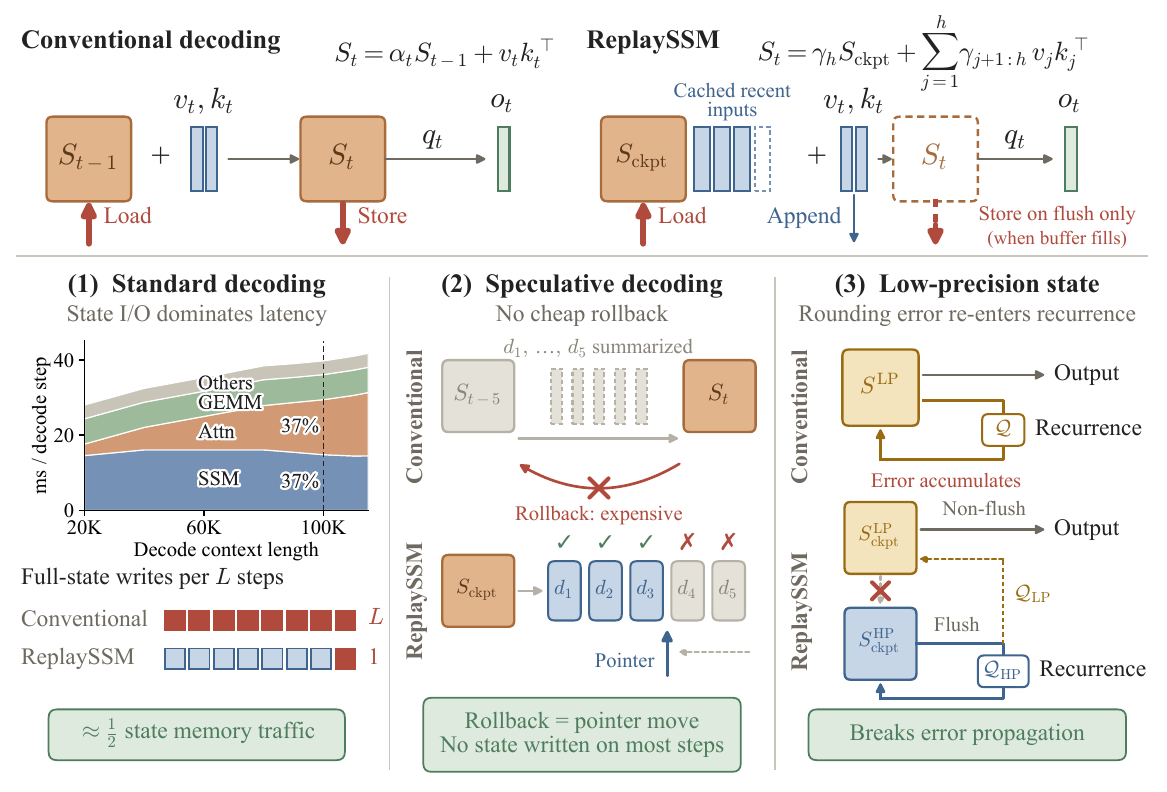
原论文 Fig. 1,p.2,Liou 等,CC BY 4.0。上方比较逐步写回与缓存输入;下方分别对应状态流量、投机回滚和低精度误差反馈。左下延迟分解来自 Nemotron-3-Super-120B-A12B-NVFP4,batch size 256、单 B300,不能视作所有模型的固定占比。原图
ReplaySSM Design
设
因此,checkpoint 与最近输入已经足以表示当前状态。这里的 replay 只重做 SSM 的局部状态计算,使用已投影好的向量和衰减系数,不重新运行历史 token 的整个模型。
标准解码每
两边都读取
缓存输入也改变了每一步必须产生的结果。下一步可以继续从 checkpoint 与 buffer 计算,因而当前步可以只输出
常规 Mamba-2 每步的路径是:从 HBM 加载
两者的关键区别是乘法结合顺序:
output-only 的标准解码流程可以写成:
持久数据:checkpoint S0;最近输入 buffer;有效长度 h;窗口 L
每步输入:(alpha, v, k, q)
1. 将 (alpha, v, k) 加入 buffer,h 增加 1。
2. 根据衰减乘积,从 S0 和 buffer 直接计算当前输出 o。
3. 若 h 达到 L:重建当前状态并写回 S0,清空 buffer,令 h = 0。
4. 返回 o,继续模型后续的 gate、skip 等计算。这是便于解释的数据流;flush 步的输出计算与状态重建可以复用工作。论文 Algorithm 1 为展示基本方法,使用的是先重建片上状态再读出输出的路径;标准解码的 output-only 推导见 Appendix C.4,不能把 Algorithm 1 本身描述成完全不物化状态。论文 §4、§5.2、Appendix C.4,pp.5–6、22
重放确实增加计算,不能只看减少的写入。若当前输入之前已有
checkpoint 的矩阵向量乘仍然存在;被削减的是每条缓存输入构造外积状态的成本,从
用资源下界解释重算与访存的取舍(AI 推导):若一步搬运
这不是无条件的运行时间等式。同一份数据必须先加载再计算;GPU 只能利用不同 warp 或独立数据块的工作隐藏部分延迟。并行度不足、启动开销或依赖等待,都可能使实际延迟明显高于这个下界。因此,额外计算能否被原来的访存等待所容纳,需要实验判断,不能仅凭“memory-bound”保证。
窗口越长,checkpoint 写入越少,但 buffer 的累计读取和重放工作越多。论文的窗口扫描验证了这种取舍,见后面的 Evaluation;
Speculative Decoding
常规快照路径从最后已接受的状态出发,依次处理
设步骤开始时已有
其中
具体的数据流为:
- 在
条已提交记录之后追加本轮 条输入,保持 不变。 - 从同一个 checkpoint 和带因果掩码的 buffer 计算所有验证输出。
- 若
,只将原先的 条已提交记录合入 checkpoint,并从逻辑 buffer 中移除;本轮 draft 保留,不参与此次 flush。 - 采样确定本轮实际提交长度
后,将有效前缀推进 条。未 flush 时新长度为 ,已 flush 时为 ;拒绝部分留在无效区域,下一轮覆盖即可。
flush 必须排除尚未确认的 draft。 否则拒绝的更新已经进入 checkpoint,单纯移动 buffer 指针就无法恢复正确状态。论文采用容量
作者博客使用总容量
Gated DeltaNet
Qwen3.5 使用的 Gated DeltaNet(GDN)还包含擦除项,
改写后,buffer 缓存校正向量
ReplaySSM Kernel Design
Mamba-2 的一组 value heads 共享 key 和 query。若每个处理状态分块的线程块都计算
ring buffer 解决的是保留 draft 时的数据搬移。flush 移除旧的 committed prefix 后,本轮输入成为新的逻辑起点;不需要把它们物理复制到数组开头。接受长度确定后,仅更新有效长度和 ring origin。连续批处理中的不同请求具有不同 buffer 位置与接受长度,避免逐行搬移尤其有用。
为适配 CUDA Graph,论文将 flush 决策保存在逐请求的设备端数据中,由 kernel 读取:可在 decode kernel 内分支,或让独立 flush kernel 中不需要刷新的行直接退出。接受数
Evaluation
以下数值统一采用论文 arXiv:2610.13778v1。博客与论文的模型范围、窗口和部分结果不同,例如博客包含双卡 550B 配置,论文主实验为四个单卡模型;不能将两者的最大加速比当成同一组实验。
| 模型 | SSM 类型 | 权重精度 | 硬件 | SSM / Attention 层数 |
|---|---|---|---|---|
| Nemotron-3-Nano-4B | Mamba-2 | BF16 | 1×H100 80GB | 21 / 4 |
| Nemotron-3-Super-120B-A12B | Mamba-2 | NVFP4 | 1×B300 | 40 / 8 |
| Qwen3.5-4B | GDN | BF16 | 1×H100 80GB | 24 / 8 |
| Qwen3.5-122B-A10B | GDN | NVFP4 | 1×B300 | 36 / 12 |
全部性能实验使用 FP32 SSM 状态、BF16 激活,单 GPU、无 tensor parallel;B300 的功率上限为 1100W。双方在同一 vLLM build 中启用 CUDA Graph。基线采用扫描得到的最快 kernel launch 配置,而非较慢的默认 Mamba-2 配置。独立 kernel 延迟经过 warmup、使用 cold L2、报告重复测量的中位数;ReplaySSM 测量覆盖完整 replay 窗口,包含 flush。论文 §7.1、Appendix E.1–E.2,pp.25–26
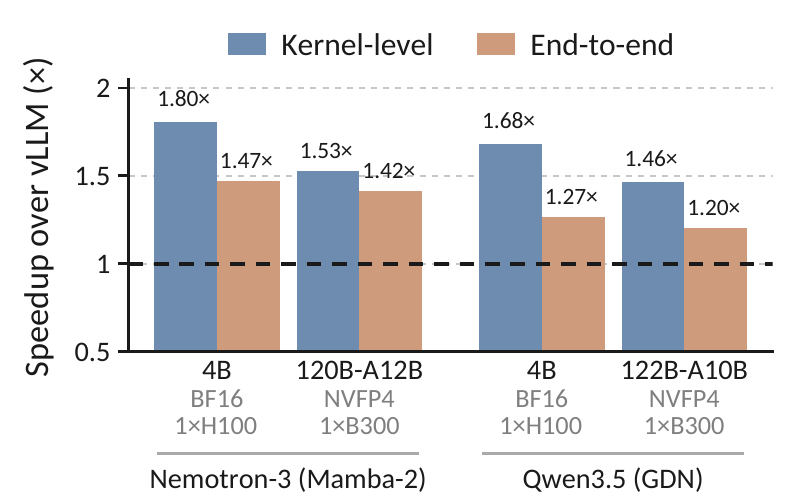
原论文 Fig. 2,p.6,Liou 等,CC BY 4.0。
| 模型 | SSM kernel 加速比 | 整模型 decode step 加速比 |
|---|---|---|
| Nemotron-3-Nano-4B | 1.80× | 1.47× |
| Nemotron-3-Super-120B-A12B | 1.53× | 1.42× |
| Qwen3.5-4B | 1.68× | 1.27× |
| Qwen3.5-122B-A10B | 1.46× | 1.20× |
整模型收益较小,因为 attention、其他 GEMM 等工作仍占时间;图中的 end-to-end 指整模型单步 decode 延迟,不是包含 prefill 的完整请求吞吐。更长上下文中 attention 的占比提高,也会限制 SSM 优化带来的整体收益。
batch 扫描给出了适用边界:
论文在
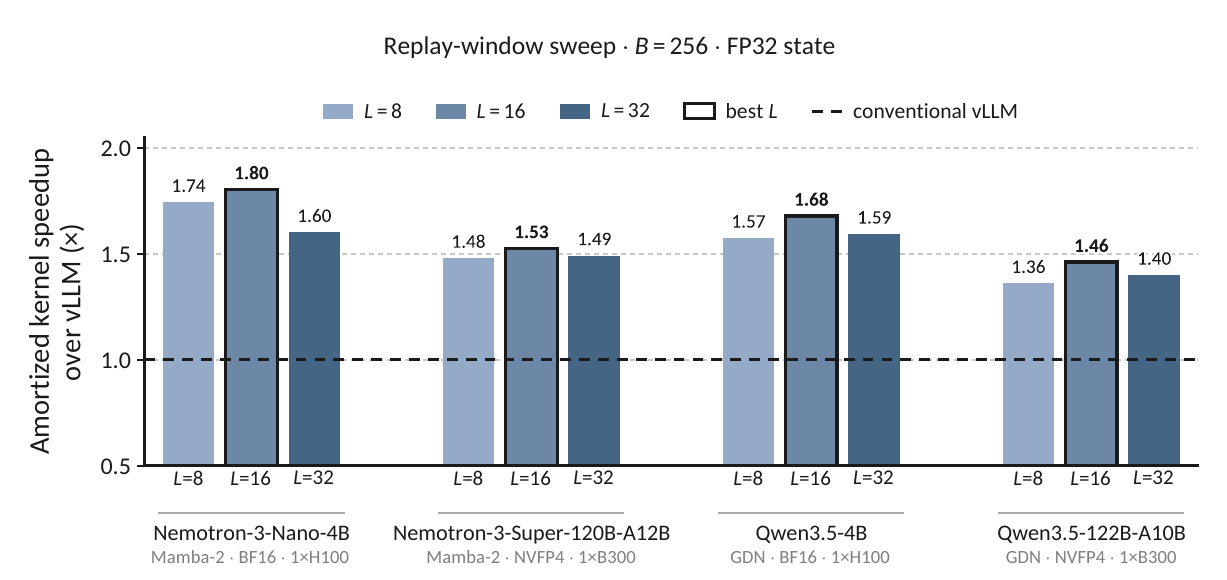
原论文 Fig. 9,p.27,Liou 等,CC BY 4.0。
四个模型在这组扫描中都以
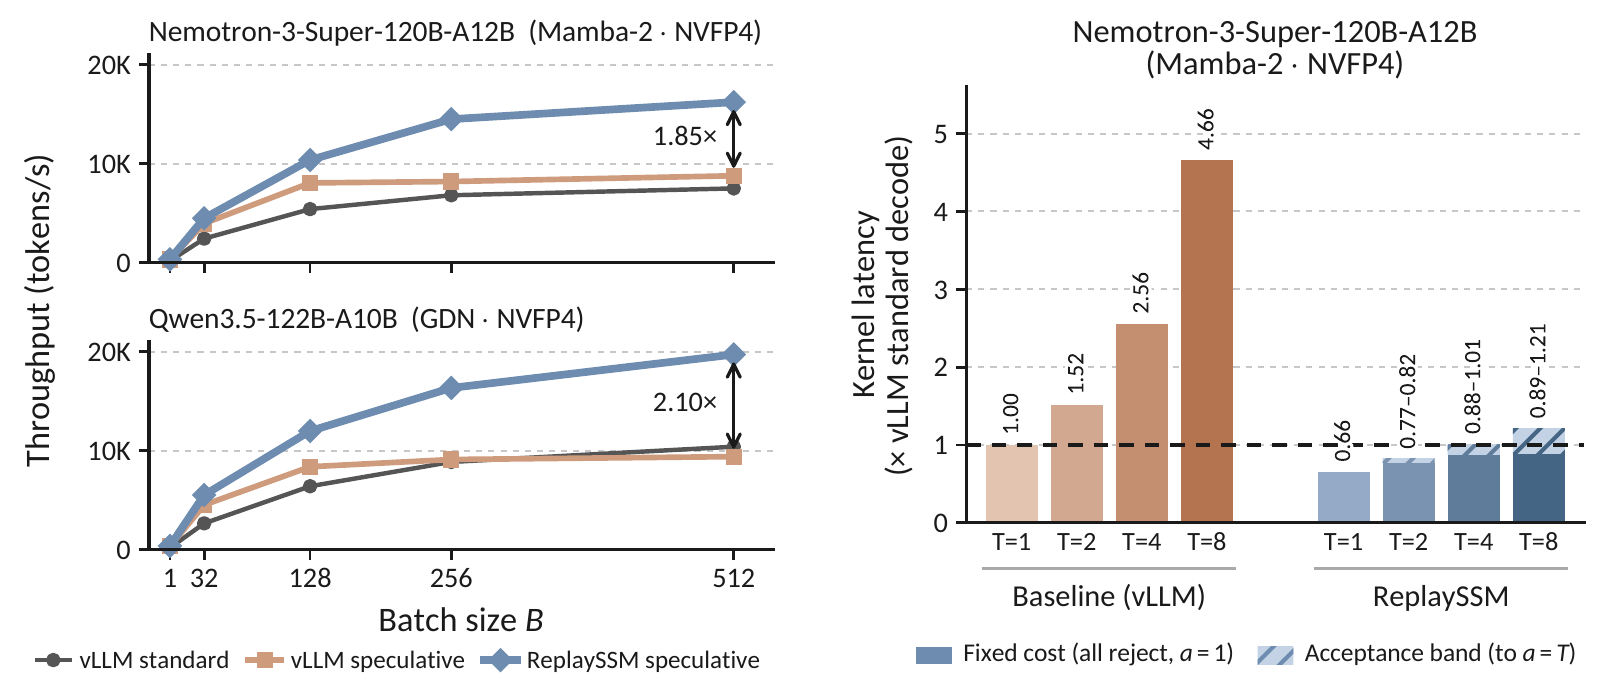
原论文 Fig. 3–4,p.7,Liou 等,CC BY 4.0。左图:每个模型单 B300,
服务实验使用两个 120B 级模型自身的 MTP head 生成 draft,输入为 GSM8K prompts,每个请求生成 256 tokens,并忽略 EOS 以固定长度。指标是计时区间内总生成 tokens / wall time,包含 prefill。两种投机实现的平均接受长度差异不超过 0.05 token,因此吞吐差距不能解释为更容易接受 draft。[论文 §7.3、Appendix E.3]
| 相对常规投机解码 | 相对标准解码 | |
|---|---|---|
| Nemotron-3-Super-120B-A12B | 1.85× | 2.16× |
| Qwen3.5-122B-A10B | 2.10× | 1.90× |
常规投机路径在
独立 kernel 实验进一步显示:当
论文比博客主线进一步讨论了低精度状态。若同一低精度状态既用于输出,也用于下一次递推,舍入误差会反复进入状态更新。ReplaySSM 可以维护两个对应同一历史的 checkpoint:非 flush 步读取低精度副本计算输出;flush 时从较高精度副本重放已提交输入,再分别生成两个新副本。这样低精度读取副本的舍入误差不再反馈进 checkpoint 递推,但当前输出仍有读取误差,较高精度路径也仍有舍入误差。[论文 §6、Algorithm 3]
GDN 还需保留原始
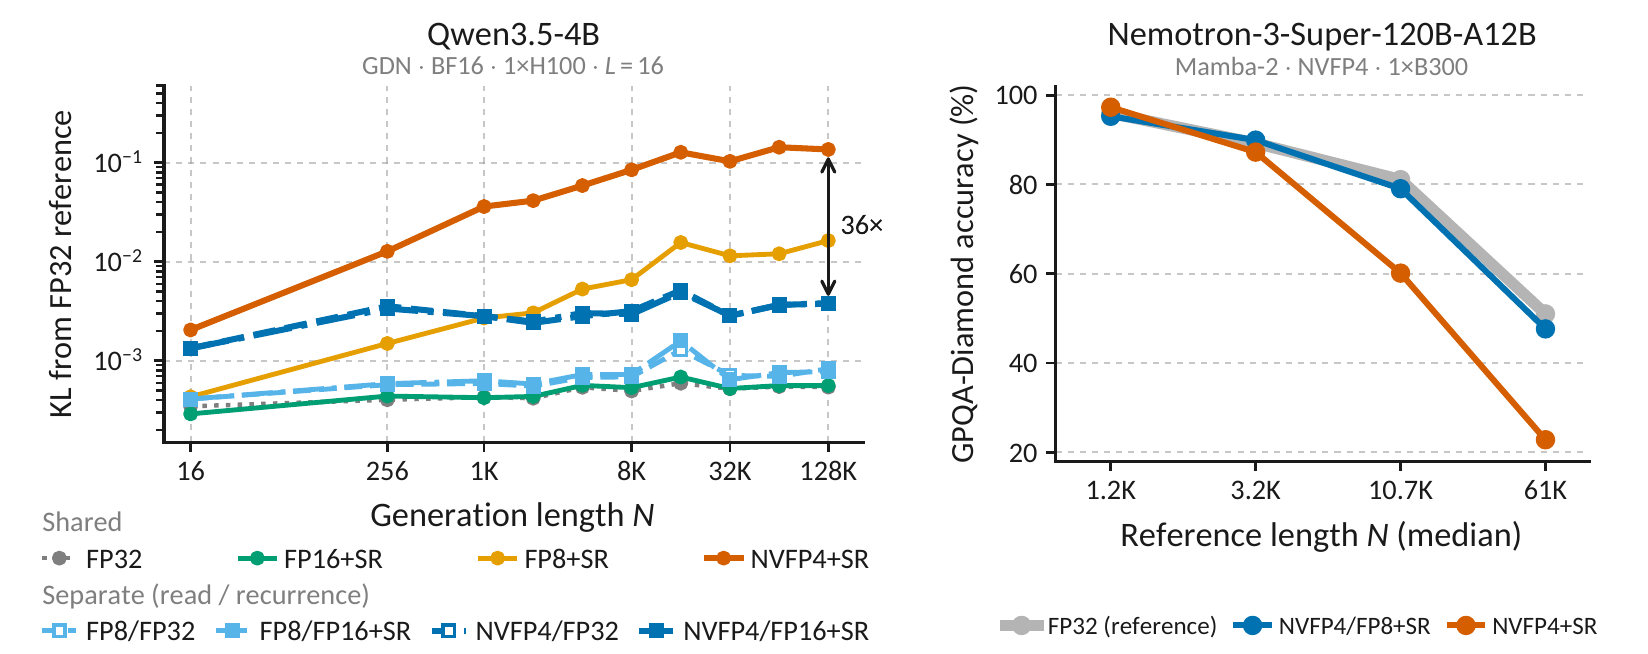
原论文 Fig. 5–6,p.8,Liou 等,CC BY 4.0。左图在 PG-19 teacher forcing 下测量相对 FP32 的输出 KL;右图按 FP32 参考生成长度四分位分组,比较 Nemotron-3-Super 的 GPQA-Diamond 准确率。图中 SR 为 stochastic rounding。原图
精度实验只量化 decode 状态,prefill 使用完整精度,模型权重保持发布格式,采用标准解码。KL 与准确率来自集成在 vLLM 中的 Triton 模拟量化;低精度延迟另外使用 CuTe DSL kernel 测量,不能将这些精度结果当成前述 FP32 性能实验已实现的额外整模型加速。
在 Qwen3.5-4B、PG-19 的 128K 长度处,将共享 NVFP4 checkpoint 改为 NVFP4 读取、FP32 递推后,
下表摘录论文 Table 2,数值为四个模型平均准确率相对 FP32 的百分点变化;Separate 的顺序为“读取 / 递推精度”。
| Checkpoint 配置 | MMLU-Pro | GPQA-Diamond | Math-L5 |
|---|---|---|---|
| Shared NVFP4 + SR | −5.88 | −13.05 | −10.92 |
| Separate FP8 / FP16 + SR | −0.04 | −0.25 | −0.12 |
| Separate NVFP4 / FP16 + SR | −0.15 | −2.36 | −0.10 |
| Separate NVFP4 / FP8 + SR | −0.40 | −1.77 | −0.38 |
平均值会掩盖模型差异。例如 Nano-4B 在两种 Separate NVFP4 配置下仍损失 6.7 / 5.6 个 GPQA 百分点,不能概括为“分离后无精度损失”。Fig. 6 还显示,Nemotron-3-Super 使用共享 NVFP4 时,在参考生成较长的两组上分别下降 20.9 / 28.2 个百分点;这与递推误差随长生成累积的解释一致,但它是按参考长度分组的观察,不是独立控制生成长度的因果消融。论文 Table 2、§7.4,pp.9–10
GPQA-Diamond 每个配置有 594 次生成,按问题聚类计算的标准误约为 2.5–3 个百分点,较小差异不足以支持明确的精度排序。部分损失还与生成未完成有关:Nemotron-3-Super 的共享 NVFP4 配置有 20.7% 的生成触及长度预算,FP32 为 5.7%;在两种配置都完成的配对样本中,差距缩小到 2.8 个百分点。论文 Appendix E.4.6,p.32